Für eine kleine Web-App läuft JavaScript-Error-Tracking auf vier Dinge hinaus: jeden nicht abgefangenen Fehler und jede unbehandelte Promise-Rejection fangen, Wiederholungen gruppieren, damit hundert Abstürze als ein Bug erscheinen, minifizierte Stack-Traces in deinen eigenen Code zurückübersetzen und die Console- und Netzwerkaktivität der Minute davor aufbewahren. Dashboards, Alert-Regeln und Performance-Tracing können warten, bis es jemandes Job ist, sie im Blick zu behalten.
Dieser Beitrag geht die vier Punkte durch, die Browser-Details hinter jedem und das Rauschen, das du wegwerfen kannst. Ich habe gerade die Fehlererfassung in BugDump veröffentlicht, deshalb stammen die Beispiele daher, aber die Mechanik ist dieselbe, egal welches Tool du nimmst.
Niemand sagt dir Bescheid
Wenn ein Checkout-Button nichts tut, versuchen es die meisten noch einmal, seufzen und gehen. Ein paar melden sich, meist Tage später, mit einer Beschreibung wie „auf meinem Handy geht's nicht“. Der Fehler war die ganze Zeit da, in einer Console, auf die niemand geschaut hat.
Das ist das Argument für Error-Tracking in einem Satz: Es macht aus den Bugs, die niemand meldet, eine Liste, die du abarbeiten kannst. Für eine kleine App zählt diese Liste mehr als jedes Diagramm, das man darüber legt.
1. Fehler fangen: zwei Events
Browser melden Fehler über zwei Events, und du brauchst beide:
window.addEventListener('error', (event) => {
  report(event.error ?? new Error(event.message));
});

window.addEventListener('unhandledrejection', (event) => {
  report(event.reason);
});
error feuert bei einer Exception, die nichts abgefangen hat: ein Tippfehler, ein Property-Zugriff auf undefined, der Aufruf einer Funktion, die es nicht gibt. unhandledrejection feuert bei einem Promise, das fehlgeschlagen ist, ohne dass jemand zuhört. In Code, der überwiegend aus async und await besteht, landen die meisten Fehler bei diesem zweiten Event. Ein fetch, das eine HTML-Fehlerseite bekommt und darauf response.json() aufruft, berührt window.onerror nie.
Drei Dinge liefern dir diese Events nicht:
Fehler, die du selbst abfängst. Ein
try/catch, das eine freundliche Meldung zeigt, versteckt den Fehler auch vor beiden Events. Wenn du trotzdem davon wissen willst, melde ihn aus demcatch-Block.Die Details von Fehlern aus anderen Ursprüngen. Ein Script von einer anderen Domain, ohne CORS geladen, meldet seine Fehler nur als
Script error., ohne Datei, Zeile oder Stack. Der Browser versteckt das mit Absicht. Lade das Script mitcrossorigin="anonymous"und liefere es mit einemAccess-Control-Allow-Origin-Header aus, oder akzeptiere, dass du nicht hineinsehen kannst.Fehler, bevor dein Tracker geladen ist. Wenn das Tracking-Script zuletzt lädt, sind die Abstürze beim Start verloren. Lade es früh.
Die Listener sind der einfache Teil. Der Rest dieses Beitrags dreht sich darum, was nach report() passiert.
2. Gruppieren: tausend Ereignisse, ein Bug
Ein Fehler, der bei jedem Besuch einer Seite auftritt, kommt tausendfach an. Du willst eine Zeile mit einem Zähler, also entscheidet die Gruppierung, ob die Liste überhaupt brauchbar ist.
Der übliche Ansatz, und der, den ich nutze, baut einen Fingerprint aus drei Teilen:
dem Fehlertyp, etwa
TypeError;der Meldung ohne ihre variablen Teile:
Order 58213 not foundundOrder 61007 not foundsind derselbe Fehler, also werden Zahlen, URLs, E-Mail-Adressen und IDs zu Platzhaltern;den obersten paar Frames deines eigenen Codes, nach Datei und Funktion statt nach Zeile, damit eine unabhängige Änderung weiter oben in der Datei die Gruppe nicht aufspaltet.
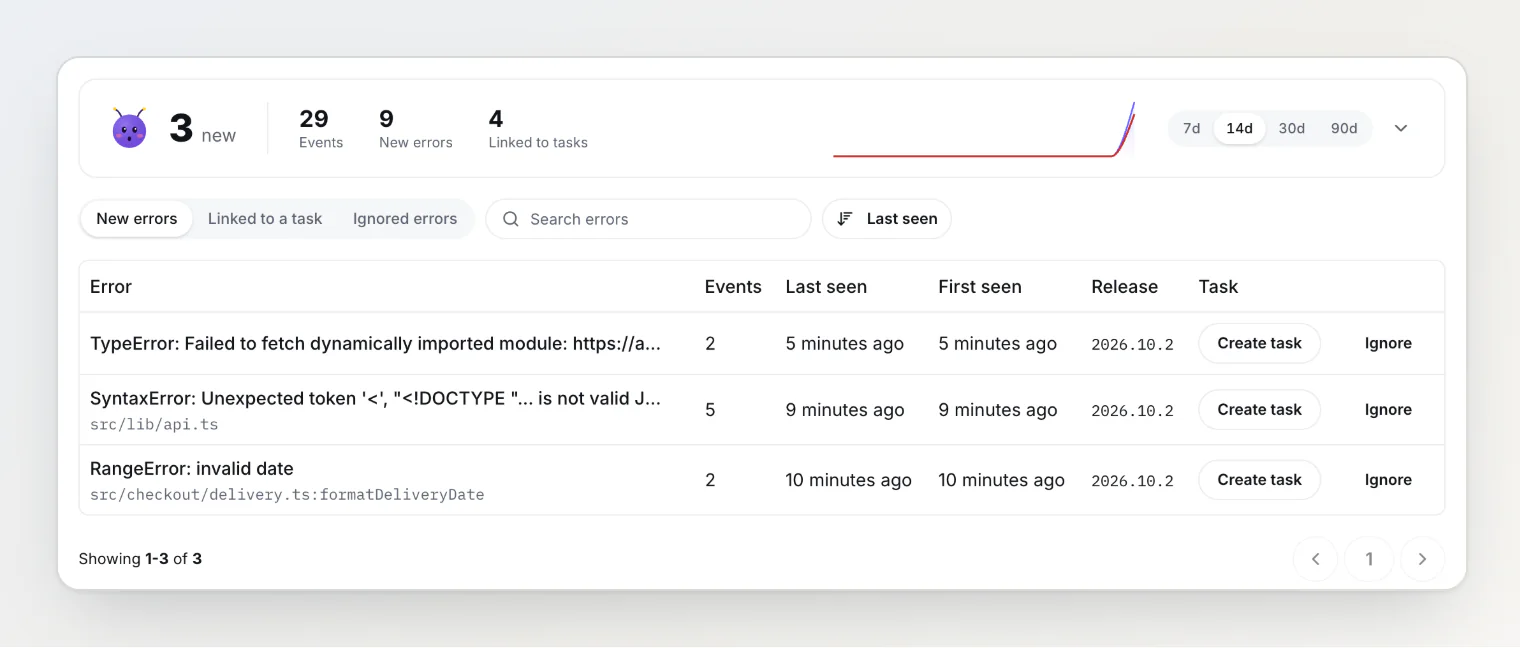
Das funktioniert gut, aber nicht perfekt. Browser formulieren denselben Fehler unterschiedlich: Chrome sagt Cannot read properties of undefined (reading 'total'), Safari sagt undefined is not an object (evaluating 'cart.summary.total'). Auch Stacks bauen sie unterschiedlich, Firefox fügt einen Frame für die Stelle hinzu, an der ein Callback registriert wurde. Ab und zu kommt ein Bug also als zwei Fehler an, einer pro Browser. Ein Tool sollte dich beide an dieselbe Aufgabe hängen und weitermachen lassen, statt so zu tun, als passiere das nie.
3. Rauschen: was du zuerst wegwirfst
Manche Fehler sind nicht deine, und manche sind eigentlich gar keine Fehler. Verwirf sie, bevor sie in deiner Liste landen, sonst lohnt es sich nicht mehr, die Liste zu lesen.
Was du siehst | Warum es passiert | Was zu tun ist |
|---|---|---|
| ein Script aus einem anderen Ursprung, vom Browser verborgen | verwerfen, oder |
ein Frame in | eine Browser-Erweiterung hat Code in deine Seite eingeschleust | verwerfen |
| eine harmlose Layout-Schleife, vor der der Browser warnt | verwerfen |
| ein Adblocker hat ein Analytics-Script entfernt, das dein Code noch aufruft | ignorieren oder den Aufruf absichern |
| ein Request, den dein eigener Code abgebrochen hat | ignorieren |
Zwei weitere Regeln halten die Menge im Rahmen, ohne dass etwas verloren geht:
Jeden einzelnen Fehler einmal pro Session senden. Ein Absturz in einer Render-Schleife kann in einem Tab hunderte Male pro Sekunde feuern. Der erste sagt dir alles.
Die Rate pro Seite begrenzen. Zehn pro Minute sind für einen Tab reichlich. Alles darüber ist eine Schleife, keine neue Information.
Sampling, also nur einen Teil der Fehler zu senden, hilft erst, wenn der Traffic so groß ist, dass 10 % davon immer noch jeden Bug finden. In einer kleinen App versteckt es vor allem den seltenen Fehler, den du am dringendsten hättest sehen müssen. Lass es auf 100 %, bis die monatliche Zahl etwas anderes sagt.
4. Lesbare Stack-Traces, ohne deinen Quellcode zu veröffentlichen
Produktionscode ist minifiziert, ein roher Stack-Trace sieht also so aus:
TypeError: Cannot read properties of undefined (reading 'subtotal')
    at T (https://acme-store.com/assets/app-L5L4OHQM.js:2:1095)
    at x (https://acme-store.com/assets/app-L5L4OHQM.js:2:2081)
Eine Source Map macht daraus wieder renderCartSummary in src/cart/cart-summary.ts, Zeile 6. Der Haken ist, wo die Maps liegen. Neben deinem JavaScript ausgeliefert, funktionieren sie für die DevTools, aber sie veröffentlichen deinen Quellcode auch für alle, die den Netzwerk-Tab öffnen.
Das bessere Muster sind versteckte Source Maps (hidden source maps). Der Bundler schreibt die .map-Dateien, ohne dass dein JavaScript auf sie verweist, deine CI lädt sie zum Error-Tracker hoch, und sie erreichen deinen Server nie.
Der Tracker muss dann für jeden Frame die richtige Map finden. Die Zuordnung über Datei-URL und Release-Namen ist der alte Weg, und sie geht leicht kaputt: Ein CDN ändert die URL, ein Release-Name passt nicht, zwei Builds teilen sich einen Namen. Der zuverlässigere Weg, auf den Sentry umgestiegen ist und den ich auch nutze, ist eine Debug-ID. Ein Schritt nach dem Build berechnet aus dem Inhalt jeder Datei eine ID und schreibt sie in die Datei und in ihre Map. Zur Laufzeit registriert die Datei ihre ID, der Fehler trägt sie mit, und die Map wird allein über die ID gefunden.
In der Praxis sind das drei Befehle:
vite build --sourcemap hidden
npx @bugdump/cli sourcemaps inject dist
npx @bugdump/cli sourcemaps upload dist --release "$GIT_SHA" --delete-after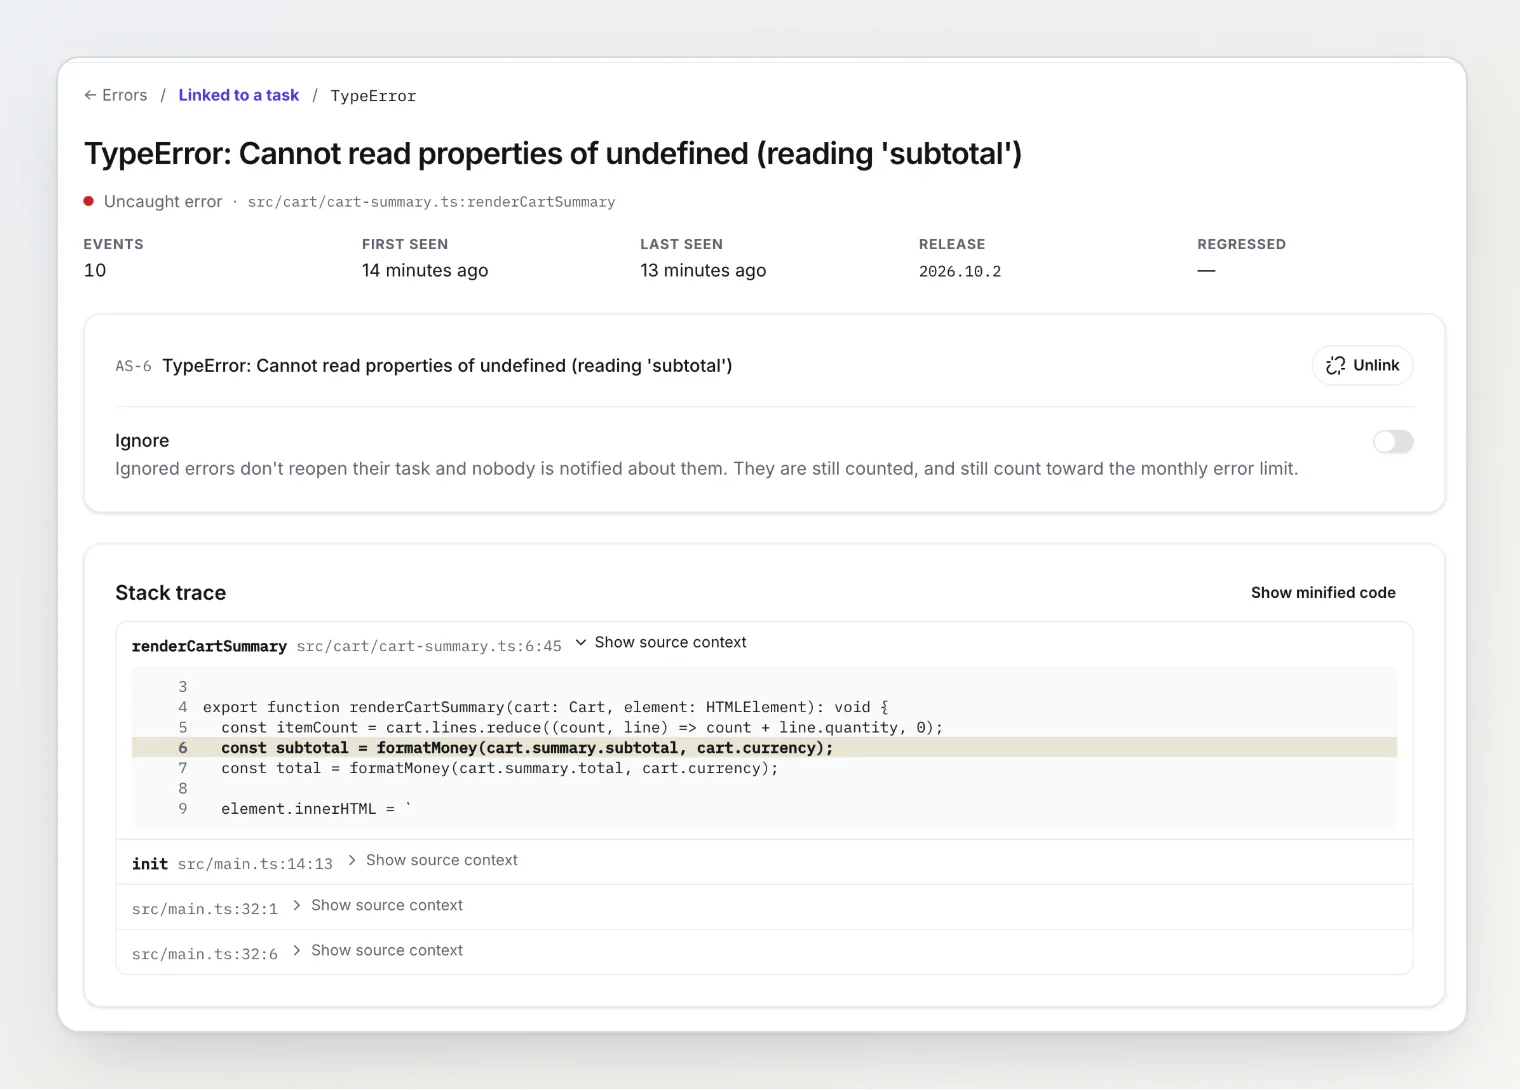
5. Die Minute vor dem Fehler
Ein Stack-Trace sagt dir, wo der Code aufgegeben hat. Warum, sagt er oft nicht.
Ein Beispiel aus meinem Demo-Shop. Der Fehler ist SyntaxError: Unexpected token '<', "<!DOCTYPE "... is not valid JSON, geworfen in einem kleinen Helper getJson(). Der Stack zeigt auf JSON.parse, was stimmt und überhaupt nicht hilft. Das Netzwerk-Log desselben Ereignisses erklärt es: GET /api/recommendations kam als 502-Seite vom Load Balancer zurück, und der Code versuchte, das HTML als JSON zu parsen.
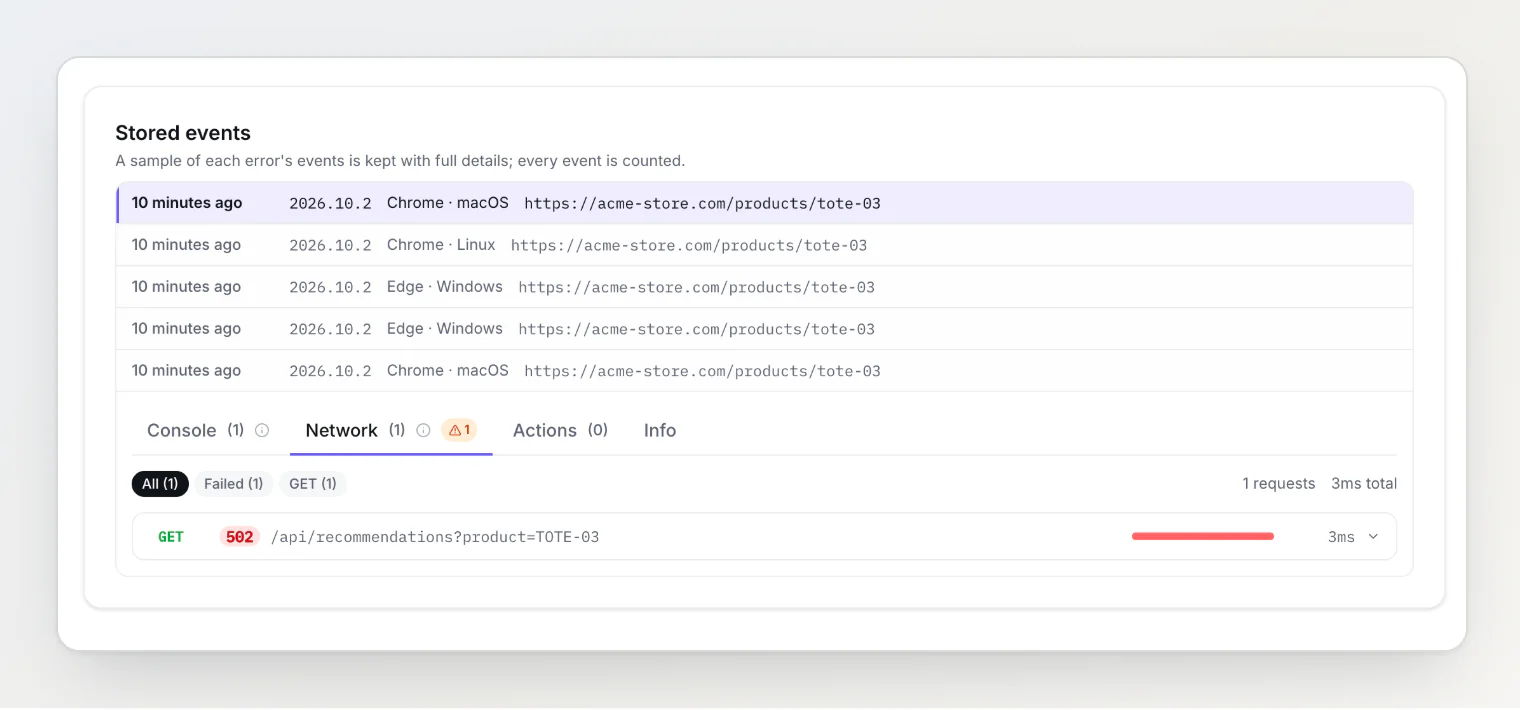
Deshalb sollte ein Fehlerereignis die letzte Minute an Console-Logs, Netzwerk-Requests und Klicks mitbringen, dieselben Belege, die ein guter Fehlerbericht hat. Ohne sie endet die Hälfte deiner Fehler als „nicht reproduzierbar“.
Die andere Hälfte des Kontexts kommt von den Menschen, die deine App nutzen. Im selben Demo-Shop entstand die Aufgabe AS-1 aus Beschwerden der Kundschaft: „Checkout button does nothing on Safari“. Für sich genommen ist das der klassische Bericht, mit dem niemand etwas anfangen kann. An derselben Aufgabe hängt jetzt der erfasste Fehler, viermal gesehen, nur in Safari und Mobile Safari: window.requestIdleCallback is not a function. Safari kennt kein requestIdleCallback, also wirft der Click-Handler, bevor die Bestellung überhaupt abgeschickt wird. Was die Kundschaft gesehen hat und die Zeile, die es erklärt, stehen auf einer Karte.
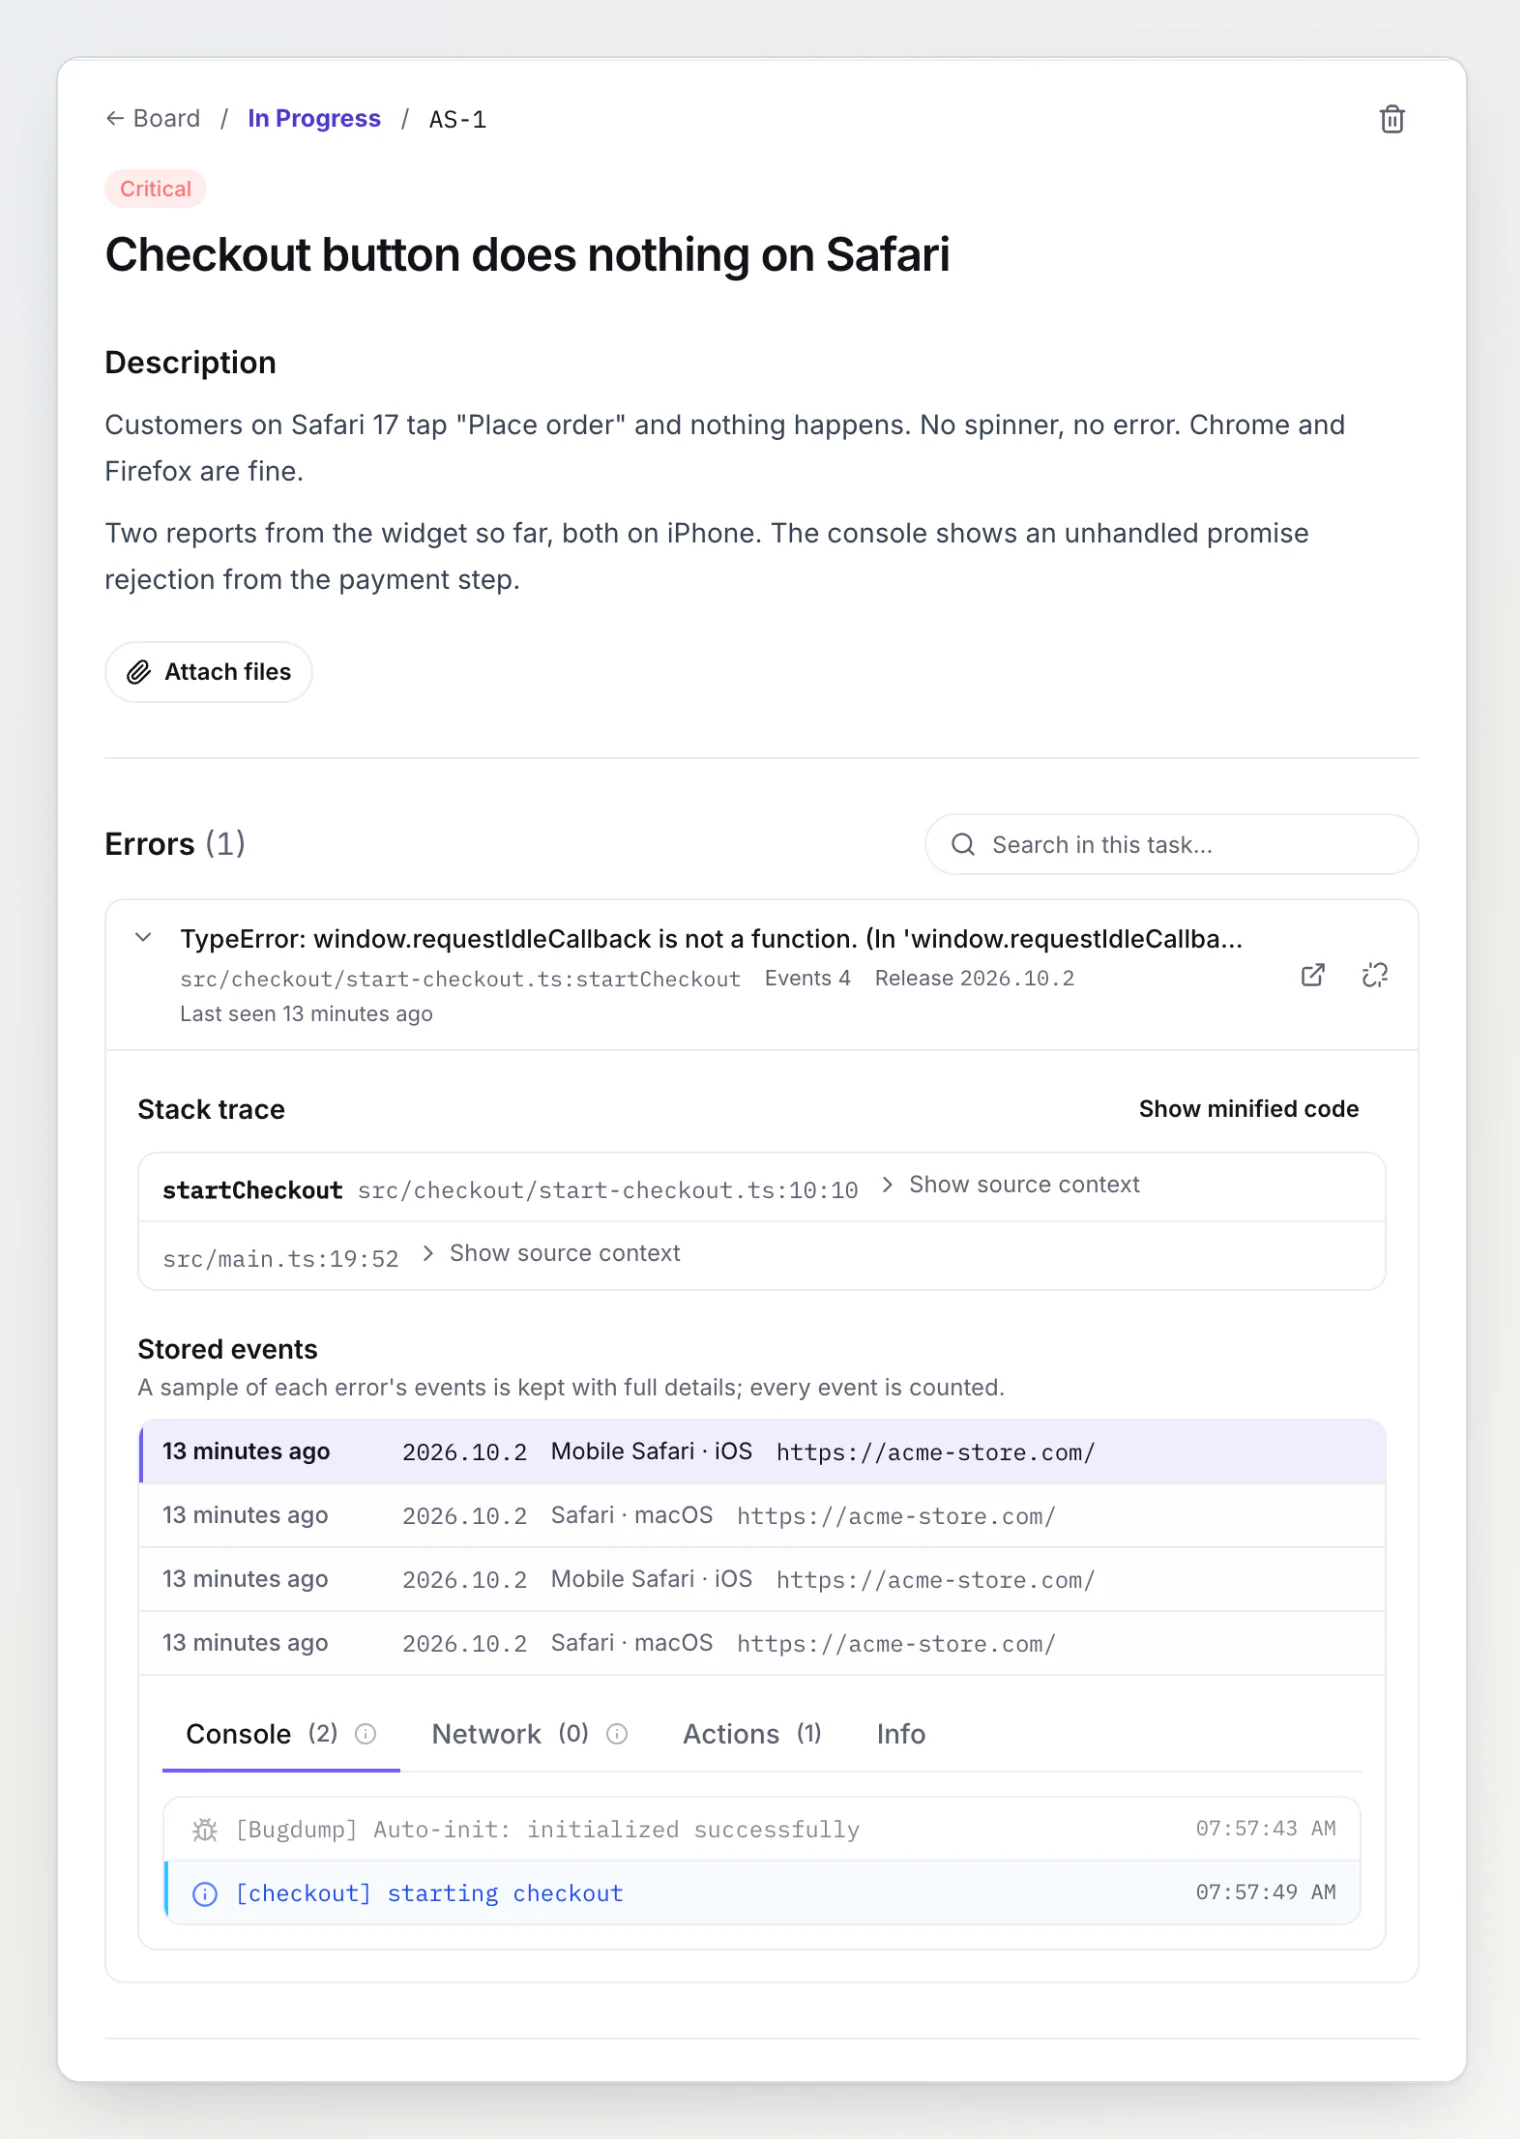
Genau das entgeht einem separaten Fehler-Dashboard. Der Bug, den jemand beschreibt, und der Fehler, den der Code wirft, sind oft derselbe Bug, und sie gehören an denselben Ort.
Brauchst du ein vollwertiges Monitoring-Tool?
Nicht immer. Spezialisierte Produkte für Error-Monitoring tun viel mehr, als Browser-Fehler zu fangen, und wenn du brauchst, was sie zusätzlich bieten, nimm eins. Für eine kleine App sieht der ehrliche Vergleich so aus:
Fehlererfassung in deinem Bug-Tracker | Ein spezialisiertes Monitoring-Tool | |
|---|---|---|
Was es fängt | JavaScript-Fehler und Rejections im Browser | Browser-, Server- und Mobile-Fehler, dazu Performance |
Wohin Fehler gehen | auf dasselbe Board wie die Fehlerberichte, die du bekommst | in einen separaten Posteingang, mit Links zu deinem Tracker |
Einrichtung | das Widget, das du schon hast | ein zweites SDK, ein zweites Projekt und eigene Alerts |
Alerts | eine Benachrichtigung bei neuen und wiederkehrenden Fehlern | Regeln, Schwellenwerte und On-Call-Routing |
Gut geeignet für | kleine Web-Apps, ein kleines Entwicklungsteam | Teams mit On-Call, mehreren Services und SLOs |
Wenn deine App aus einem Frontend und einer API besteht und dieselben zwei, drei Leute die Fehlerberichte lesen und die Fehler beheben, heißt ein einziges Board: weniger einzurichten und weniger zu prüfen. Sobald du ein Backend überwachen musst, eine On-Call-Rotation oder ein Performance-Budget hast, verdient sich ein spezialisiertes Tool seinen Platz.
Checkliste für eine kleine App
Höre auf
errorundunhandledrejection, und lade den Tracker früh.Melde die Fehler, die du selbst abfängst, wenn sie dir noch wichtig sind.
Setze bei jedem Build ein
release, damit du einen neuen Bug von einem alten Tab unterscheiden kannst.Baue mit versteckten Source Maps und lade sie aus der CI hoch. Deploye die Maps nie.
Verwirf Fehler aus Erweiterungen,
Script error.und harmlose Browser-Warnungen direkt an der Quelle.Sende jeden Fehler einmal pro Session und lass Sampling aus, bis die Menge es verlangt.
Mach aus Fehlern Aufgaben neben deinen Fehlerberichten, nicht einen zweiten Posteingang, den niemand öffnet.
FAQ
Macht Error-Tracking meine Seite langsamer? Nicht messbar. Die beiden Listener tun nichts, bis etwas fehlschlägt, und ein vernünftiger Tracker sendet jeden einzelnen Fehler einmal pro Session, im Hintergrund.
Was bedeutet „Script error.“? In einem Script aus einem anderen Ursprung ist ein Fehler passiert, und der Browser hat die Details verborgen. Setz crossorigin="anonymous" an diesen Script-Tag und lass seinen Server Access-Control-Allow-Origin senden, oder verwirf diese Fehler: Ohne Details gibt es nichts, womit du arbeiten kannst.
Ist es sicher, Source Maps hochzuladen? Sie zu deinem Error-Tracker hochzuladen ist in Ordnung. Offen liegt dein Quellcode erst, wenn du sie öffentlich auslieferst. Baue versteckte Maps, lade sie hoch und lösche sie vor dem Deploy.
Wie viele Fehler sendet eine kleine App? Das hängt viel stärker davon ab, wie viele verschiedene Bugs du hast, als vom Traffic. Wenn jeder Fehler einmal pro Session gesendet wird, sendet eine Seite mit einem Bug ein Ereignis pro betroffenem Besuch, nicht eins pro Absturz.
So probierst du es in BugDump aus
Die Fehlererfassung gehört zum BugDump-Widget, in jedem Plan, und ist standardmäßig eingeschaltet. Der kostenlose Plan enthält 1.000 Fehlerereignisse pro Monat und Projekt. Fang mit JavaScript-Fehler automatisch erfassen an, danach kommen Lesbare Stack-Traces: Source Maps hochladen und Mit erfassten Fehlern arbeiten.
Session-Replay zum Debuggen: was vor dem Bug passiert ist – wie Session-Replay funktioniert, was es aufzeichnet und warum es zusammen mit Console- und Netzwerk-Logs aus vagen Fehlerberichten lösbare macht.
Schlanker Bug-Tracker für kleine Teams: wenn Jira zu viel ist – woran schwere Issue-Tracker in kleinen Teams scheitern und was ein schlanker Bug-Tracker wirklich braucht.
So erfasst du Console-Logs und Netzwerk-Requests aus fremden Browsern – wie du Console, Fehler, fetch und XHR instrumentierst, ohne die Seite kaputtzumachen, die du beobachtest.