Para um app web pequeno, o rastreamento de erros JavaScript se resume a quatro coisas: capturar todo erro não tratado e toda promise rejeitada sem tratamento, agrupar as repetições para que cem falhas apareçam como um bug só, transformar stack traces minificadas de volta no seu próprio código e guardar o console e a atividade de rede do minuto anterior. Dashboards, regras de alerta e tracing de performance podem esperar até que olhar para eles seja o trabalho de alguém.
Este post passa pelas quatro, pelos detalhes do navegador por trás de cada uma e pelo ruído que dá para jogar fora. Acabei de lançar a captura de erros no BugDump, então os exemplos vêm dele, mas a mecânica é a mesma em qualquer ferramenta que você escolher.
Seus usuários não vão avisar
Quando um botão de finalizar compra não faz nada, a maioria das pessoas tenta de novo, suspira e vai embora. Algumas escrevem, geralmente dias depois, com uma descrição como «não funciona no meu celular». O erro estava lá o tempo todo, num console que ninguém olhava.
Esse é o argumento a favor do rastreamento de erros numa frase: ele transforma os bugs que ninguém relata numa lista que você consegue resolver. Para um app pequeno, a lista importa mais do que qualquer gráfico desenhado em cima dela.
1. Capturando erros: dois eventos
Os navegadores relatam falhas por dois eventos, e você precisa dos dois:
window.addEventListener('error', (event) => {
  report(event.error ?? new Error(event.message));
});

window.addEventListener('unhandledrejection', (event) => {
  report(event.reason);
});
error dispara para uma exceção que nada capturou: um erro de digitação, a leitura de uma propriedade em undefined, a chamada de uma função que não existe. Já unhandledrejection dispara quando uma promise falha sem ninguém escutando. Em código que é quase todo async e await, é nesse segundo evento que a maioria dos erros vai parar. Um fetch que recebe uma página de erro em HTML e chama response.json() nela nunca chega a window.onerror.
Três coisas que esses eventos não entregam:
Erros que você mesmo captura. Um
try/catchque mostra uma mensagem amigável também esconde o erro dos dois eventos. Se você ainda quer saber dele, relate-o a partir do blococatch.Os detalhes de erros de outras origens. Um script de outro domínio, carregado sem CORS, falha como
Script error., sem arquivo, linha nem stack. O navegador esconde isso de propósito. Carregue o script comcrossorigin="anonymous"e sirva-o com um cabeçalhoAccess-Control-Allow-Origin, ou aceite que não dá para ver o que acontece dentro dele.Erros antes de o rastreador carregar. Se o script de rastreamento carrega por último, as falhas durante a inicialização se perdem. Carregue-o cedo.
Os listeners são a parte fácil. O resto deste post trata do que acontece depois de report().
2. Agrupamento: mil eventos, um bug
Um erro que atinge todos os visitantes de uma página chega milhares de vezes. Você quer uma linha com uma contagem, então é o agrupamento que decide se a lista tem alguma utilidade.
A abordagem comum, e a que eu uso, monta uma impressão digital (fingerprint) a partir de três partes:
o tipo do erro, como
TypeError;a mensagem sem as partes variáveis:
Order 58213 not foundeOrder 61007 not foundsão o mesmo erro, então números, URLs, e-mails e IDs viram marcadores;os primeiros frames do seu próprio código, por arquivo e função, não por linha, para que uma edição sem relação mais acima no arquivo não divida o grupo.
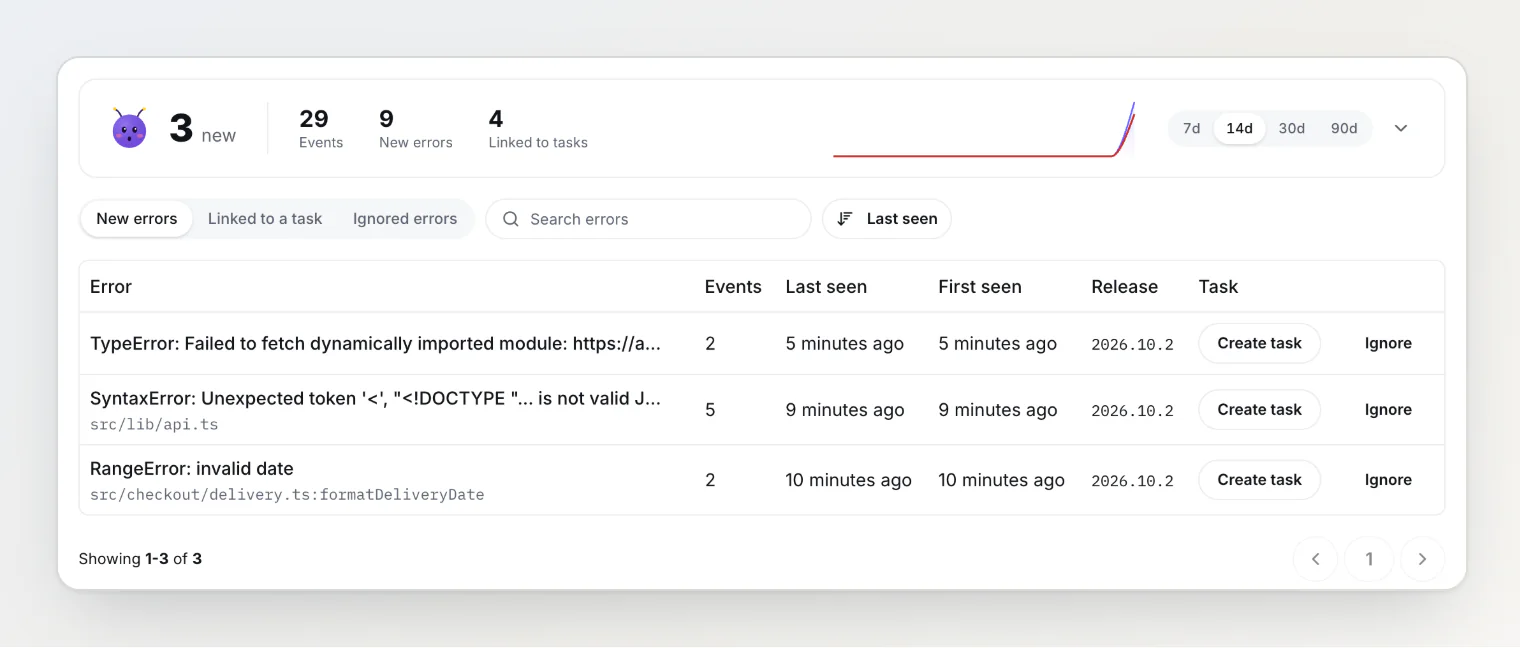
Funciona bem, mas não é perfeito. Os navegadores descrevem a mesma falha com palavras diferentes: o Chrome diz Cannot read properties of undefined (reading 'total'), o Safari diz undefined is not an object (evaluating 'cart.summary.total'). Eles também montam as stacks de um jeito diferente; o Firefox acrescenta um frame para o lugar onde um callback foi registrado. Então, de vez em quando, um bug chega como dois erros, um por navegador. Uma ferramenta deveria deixar você vincular os dois à mesma tarefa e seguir em frente, em vez de fingir que isso nunca acontece.
3. Ruído: o que jogar fora primeiro
Alguns erros não são seus, e alguns nem são erros de verdade. Descarte-os antes que cheguem à sua lista, ou a lista deixa de valer a leitura.
O que você vê | Por que acontece | O que fazer |
|---|---|---|
| um script de outra origem, escondido pelo navegador | descartar, ou adicionar |
um frame em | uma extensão do navegador injetou código na sua página | descartar |
| um loop de layout inofensivo sobre o qual o navegador avisa | descartar |
| um bloqueador de anúncios removeu um script de analytics que seu código ainda chama | ignorar, ou proteger a chamada |
| uma requisição que o seu próprio código cancelou | ignorar |
Mais duas regras mantêm o volume sob controle sem perder nada:
Envie cada erro distinto uma vez por sessão. Uma falha dentro de um loop de renderização pode disparar centenas de vezes por segundo numa aba. O primeiro evento já diz tudo.
Limite a taxa por página. Dez por minuto é mais que suficiente para uma aba. Qualquer coisa acima disso é um loop, não informação nova.
A amostragem, que envia só uma parte dos erros, ajuda quando o tráfego é grande o bastante para que 10% dele ainda encontre todos os bugs. Num app pequeno, ela quase só esconde o erro raro que você mais precisava ver. Deixe em 100% até a contagem mensal dizer o contrário.
4. Stack traces legíveis sem publicar o seu código-fonte
O código de produção é minificado, então uma stack trace crua fica assim:
TypeError: Cannot read properties of undefined (reading 'subtotal')
    at T (https://acme-store.com/assets/app-L5L4OHQM.js:2:1095)
    at x (https://acme-store.com/assets/app-L5L4OHQM.js:2:2081)
Um source map transforma isso de volta em renderCartSummary em src/cart/cart-summary.ts, linha 6. O problema é onde os maps ficam. Servi-los ao lado do seu JavaScript funciona para o DevTools e também publica o seu código-fonte para qualquer pessoa que abrir a aba de rede.
O padrão melhor são os source maps ocultos (hidden). O bundler gera os arquivos .map sem apontar o seu JavaScript para eles, o seu CI os envia para o rastreador de erros, e eles nunca chegam ao seu servidor.
Depois, o rastreador precisa achar o map certo para cada frame. Associar pela URL do arquivo e pelo nome da release é o jeito antigo, e ele quebra fácil: uma CDN muda a URL, um nome de release não bate, dois builds compartilham um nome. O jeito mais confiável, para o qual o Sentry migrou e que eu também uso, é um debug ID. Uma etapa depois do build calcula um ID a partir do conteúdo de cada arquivo e o grava no arquivo e no map dele. Em tempo de execução, o arquivo registra seu ID, o erro o carrega, e o map é encontrado só pelo ID.
Na prática, são três comandos:
vite build --sourcemap hidden
npx @bugdump/cli sourcemaps inject dist
npx @bugdump/cli sourcemaps upload dist --release "$GIT_SHA" --delete-after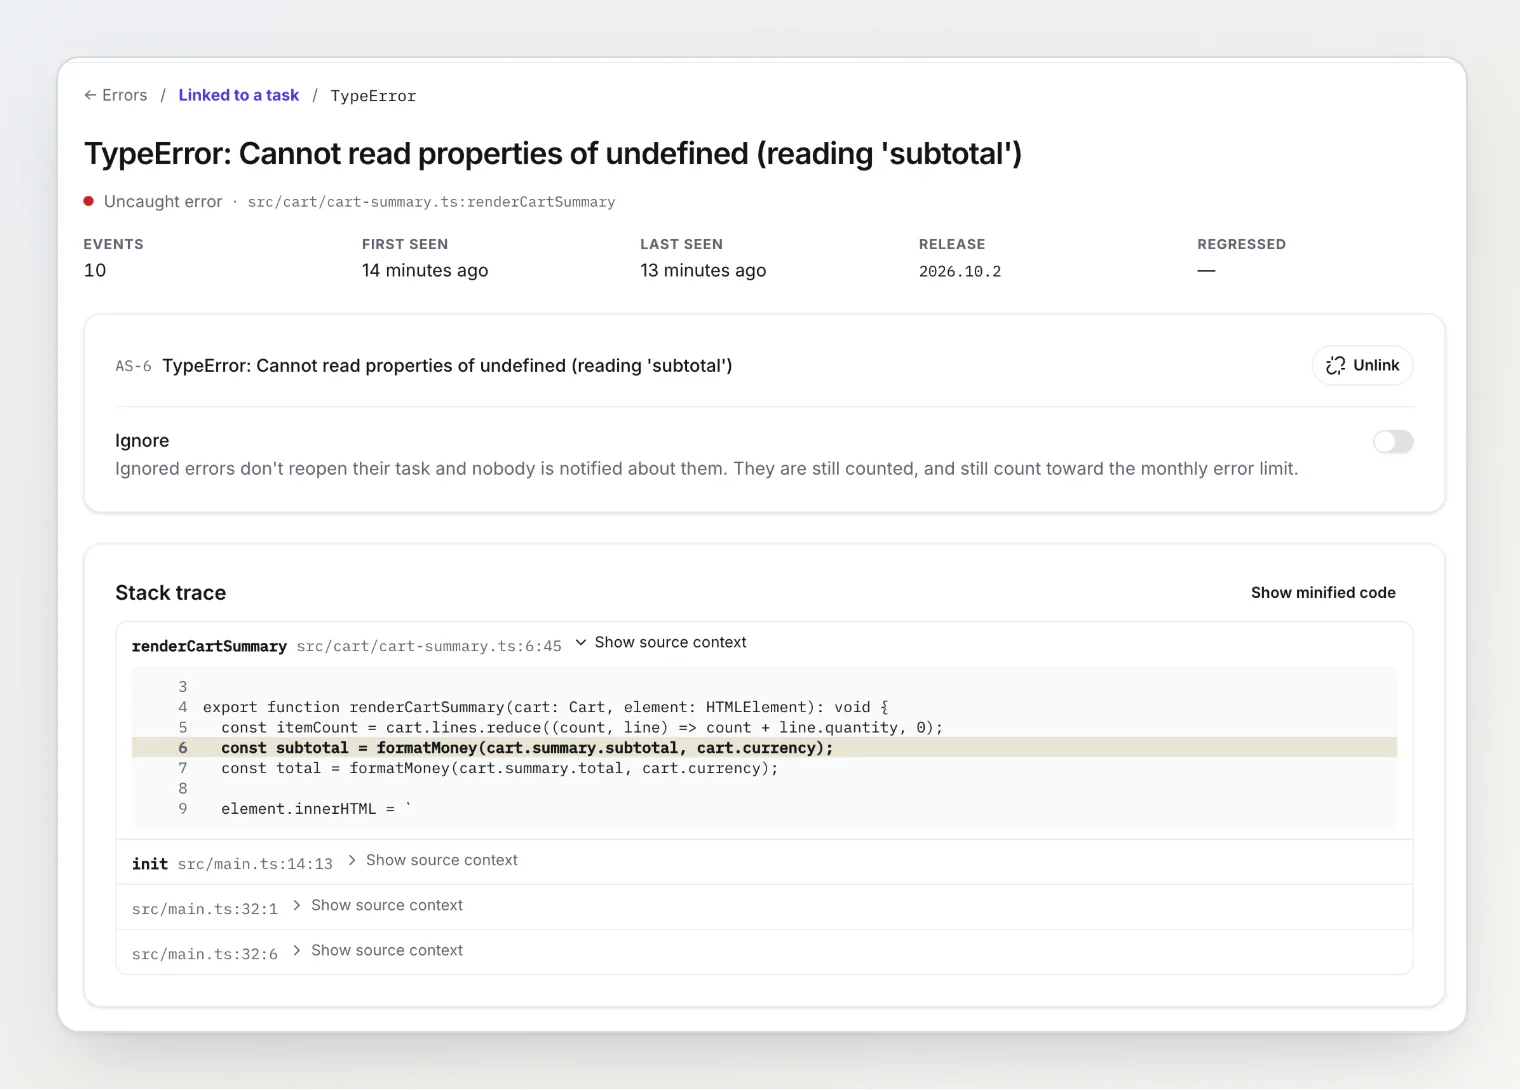
5. O minuto antes do erro
Uma stack trace diz onde o código desistiu. Muitas vezes não diz por quê.
Um exemplo da loja de demonstração. O erro é SyntaxError: Unexpected token '<', "<!DOCTYPE "... is not valid JSON, lançado dentro de um pequeno helper getJson(). A stack aponta para JSON.parse, o que está correto e não ajuda em nada. O log de rede do mesmo evento explica: GET /api/recommendations voltou como uma página 502 do balanceador de carga, e o código tentou interpretar o HTML como JSON.
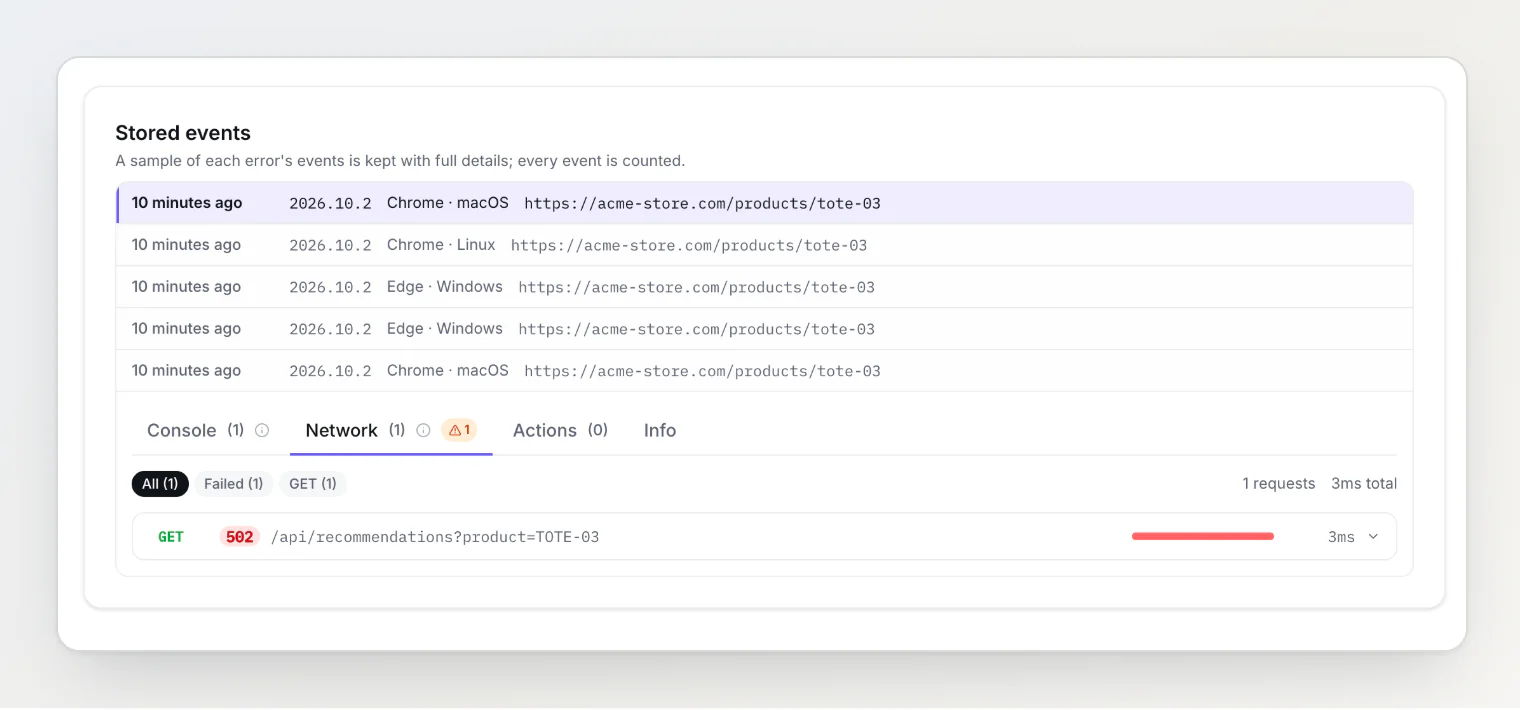
Por isso um evento de erro deveria trazer o último minuto de logs do console, requisições de rede e cliques, as mesmas evidências de um bom relatório de bug. Sem isso, metade dos seus erros acaba como «não consigo reproduzir».
A outra metade do contexto são os seus usuários. Na mesma loja de demonstração, a tarefa AS-1 foi escrita a partir de reclamações de clientes: «Checkout button does nothing on Safari». Isolado, é o relatório clássico com o qual ninguém consegue fazer nada. Na mesma tarefa agora está o erro capturado, visto quatro vezes, só no Safari e no Mobile Safari: window.requestIdleCallback is not a function. O Safari não tem requestIdleCallback, então o handler do clique lança o erro antes de o pedido ser enviado. O que os clientes viram e a linha que explica isso estão no mesmo card.
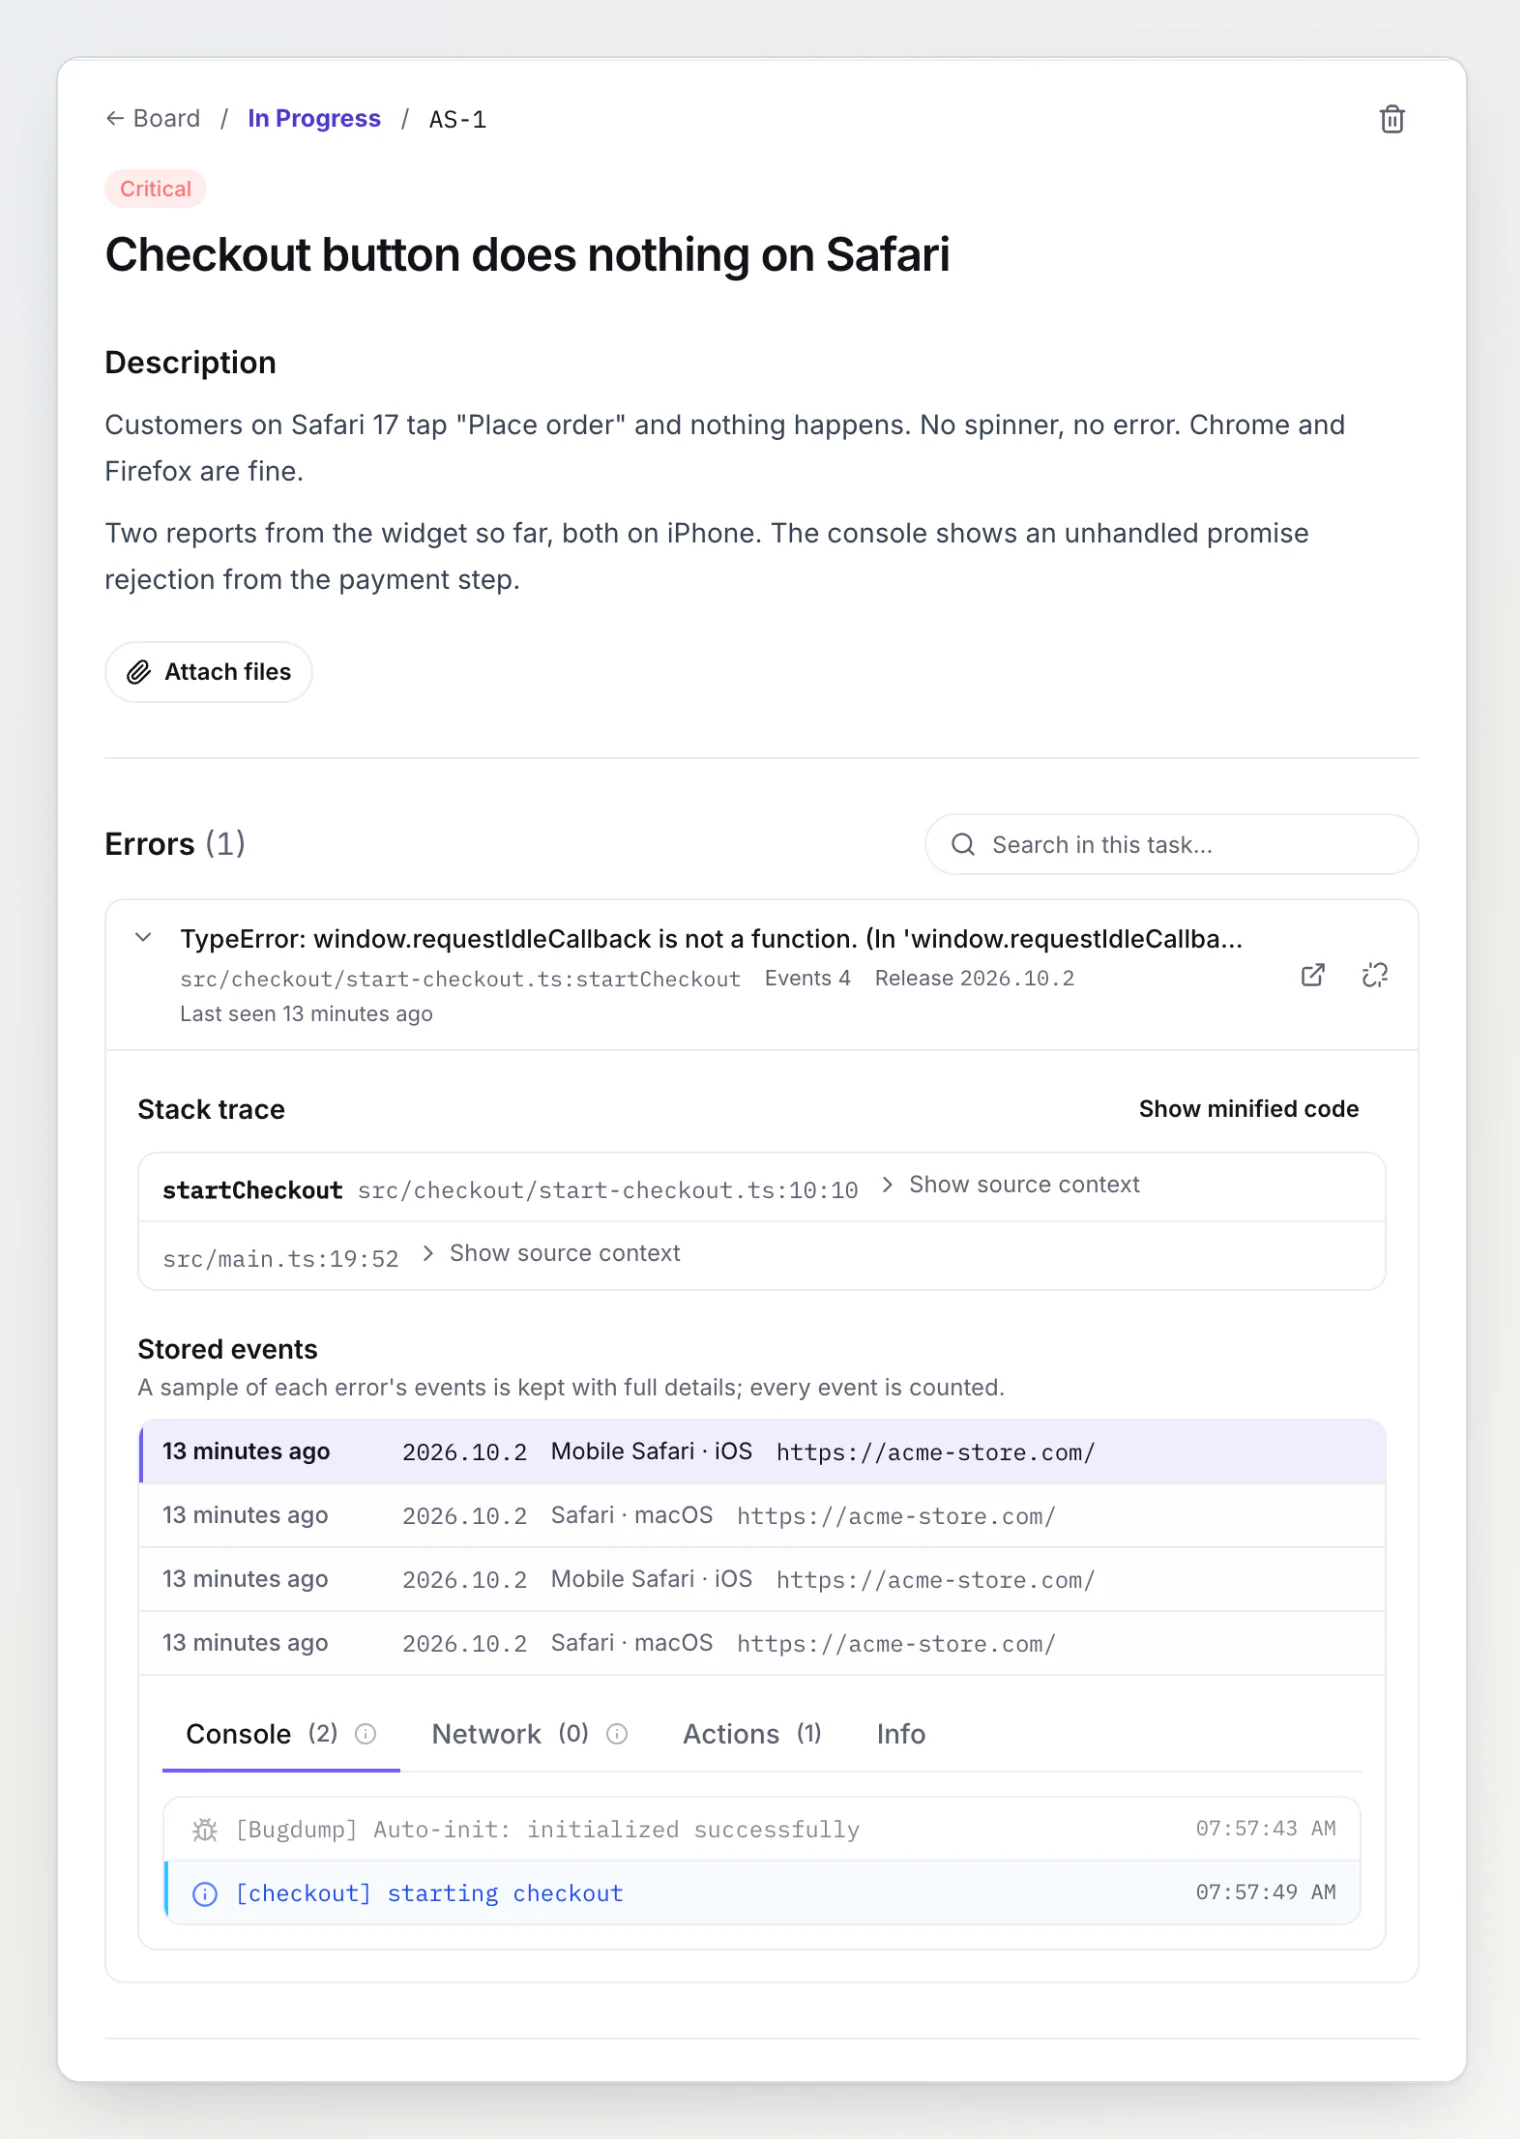
Essa é a parte que um dashboard de erros separado perde. O bug que um usuário descreve e o erro que o código lança muitas vezes são o mesmo bug, e devem ficar no mesmo lugar.
Você precisa de uma ferramenta de monitoramento completa?
Nem sempre. Produtos dedicados de monitoramento de erros fazem muito mais do que capturar erros do navegador, e, se você precisa do que eles acrescentam, use um. Para um app pequeno, a comparação honesta é esta:
Captura de erros no seu bug tracker | Uma ferramenta de monitoramento dedicada | |
|---|---|---|
O que captura | erros e promises rejeitadas de JavaScript no navegador | erros do navegador, do servidor e de mobile, além de performance |
Para onde vão os erros | o mesmo quadro dos relatórios de bug dos seus usuários | uma caixa de entrada separada, com links para o seu tracker |
Configuração | o widget que você já tem | um segundo SDK, projeto e conjunto de alertas |
Alertas | uma notificação para erros novos e que voltaram | regras, limites e roteamento de plantão |
Combina com | apps web pequenos, poucos desenvolvedores | equipes com plantão, vários serviços e SLOs |
Se o seu app é um frontend e uma API, e as mesmas duas ou três pessoas leem os relatórios de bug e corrigem os erros, um quadro só é menos coisa para configurar e menos coisa para checar. Quando você tem um backend para monitorar, um rodízio de plantão ou um orçamento de performance, uma ferramenta dedicada se paga.
Checklist para um app pequeno
Escute
erroreunhandledrejection, e carregue o rastreador cedo.Relate os erros que você mesmo captura, quando ainda se importa com eles.
Defina uma
releaseem todo build, para distinguir um bug novo de uma aba antiga.Gere source maps ocultos no build e envie-os pelo CI. Nunca faça deploy dos maps.
Descarte na origem os erros de extensões, o
Script error.e os avisos inofensivos do navegador.Envie cada erro uma vez por sessão e deixe a amostragem desligada até o volume exigir.
Transforme erros em tarefas ao lado dos seus relatórios de bug, não numa segunda caixa de entrada que ninguém abre.
Perguntas frequentes
O rastreamento de erros deixa o meu site mais lento? Não de um jeito que você consiga medir. Os dois listeners não fazem nada até algo falhar, e um rastreador razoável envia cada erro distinto uma vez por sessão, em segundo plano.
O que significa «Script error.»? Aconteceu um erro num script de outra origem e o navegador escondeu os detalhes. Adicione crossorigin="anonymous" a essa tag script e faça o servidor dele enviar Access-Control-Allow-Origin, ou descarte esses erros: sem detalhes, não há o que fazer.
É seguro enviar source maps? Enviá-los para o seu rastreador de erros não tem problema. O que expõe o seu código-fonte é servi-los publicamente. Gere maps ocultos, envie-os e apague-os antes do deploy.
Quantos erros um app pequeno vai enviar? Isso depende muito mais de quantos bugs distintos você tem do que do tráfego. Com cada erro enviado uma vez por sessão, uma página com um bug envia um evento por visita afetada, não um por falha.
Testando no BugDump
A captura de erros faz parte do widget do BugDump, em todos os planos, e vem ligada por padrão. O plano Grátis inclui 1.000 eventos de erro por mês por projeto. Comece por Capturar erros JavaScript automaticamente, depois veja Stack traces legíveis: enviando source maps e Trabalhando com os erros capturados.
Leia também
Replay de sessão para depuração: veja o que o usuário fez antes do bug — como funciona o replay de sessão e por que ele, junto com console e rede, torna um relatório vago possível de diagnosticar.
Como capturar logs do console e requisições de rede do navegador do usuário — como instrumentar console, erros, fetch e XHR sem quebrar a página que você está monitorando.
Bug tracker leve para equipes pequenas: quando o Jira é demais — o que uma equipe pequena precisa de um bug tracker e como escolher um que os usuários alimentem de verdade.