Pour une petite application web, le suivi des erreurs JavaScript se résume à quatre choses : capter chaque erreur non interceptée et chaque rejet de promesse non géré, regrouper les répétitions pour qu'une centaine de crashs se lise comme un seul bug, retraduire les stack traces minifiées vers votre propre code, et garder l'activité de la console et du réseau de la minute précédente. Les tableaux de bord, les règles d'alerte et le tracing de performance peuvent attendre que quelqu'un ait pour métier de les surveiller.
Cet article passe en revue les quatre, les détails du navigateur derrière chacun, et le bruit que vous pouvez jeter. Je viens d'ajouter la capture d'erreurs à BugDump, donc les exemples en viennent, mais la mécanique est la même quel que soit l'outil choisi.
Vos utilisateurs ne vous le diront pas
Quand un bouton de paiement ne fait rien, la plupart des gens réessaient, soupirent et partent. Quelques-uns écrivent, en général des jours plus tard, avec une description du genre « ça marche pas sur mon téléphone ». L'erreur était là depuis le début, dans une console que personne ne regardait.
Voilà l'argument du suivi d'erreurs en une phrase : il transforme les bugs que personne ne signale en une liste que vous pouvez traiter. Pour une petite app, la liste compte plus que n'importe quel graphique dessiné par-dessus.
1. Capter les erreurs : deux événements
Les navigateurs signalent les échecs par deux événements, et il vous faut les deux :
window.addEventListener('error', (event) => {
  report(event.error ?? new Error(event.message));
});

window.addEventListener('unhandledrejection', (event) => {
  report(event.reason);
});
error se déclenche pour une exception que rien n'a interceptée : une faute de frappe, une propriété lue sur undefined, l'appel d'une fonction qui n'existe pas. unhandledrejection couvre une promesse qui a échoué sans que personne ne l'écoute. Dans du code écrit surtout en async et await, c'est par ce second événement que passent la plupart des erreurs. Un fetch qui reçoit une page d'erreur HTML et appelle response.json() dessus ne touche jamais window.onerror.
Trois choses que ces événements ne vous donneront pas :
Les erreurs que vous interceptez vous-même. Un
try/catchqui affiche un message aimable cache aussi l'erreur aux deux événements. Si vous voulez quand même en être informé, signalez-la depuis le bloccatch.Le détail des erreurs venant d'autres origines. Un script d'un autre domaine, chargé sans CORS, échoue en
Script error.sans fichier, ligne ni pile. Le navigateur le masque volontairement. Chargez le script aveccrossorigin="anonymous"et servez-le avec un en-têteAccess-Control-Allow-Origin, ou acceptez de ne pas voir ce qui s'y passe.Les erreurs survenues avant le chargement de votre tracker. Si le script de suivi se charge en dernier, les crashs du démarrage sont perdus. Chargez-le tôt.
Les listeners sont la partie facile. La suite de cet article porte sur ce qui se passe après report().
2. Regroupement : mille événements, un bug
Une erreur qui touche chaque visiteur d'une page arrive des milliers de fois. Vous voulez une seule ligne avec un compteur : c'est le regroupement qui décide si la liste est utilisable ou non.
L'approche habituelle, et celle que j'utilise, construit une empreinte à partir de trois éléments :
le type d'erreur, comme
TypeError;le message, sans ses parties variables :
Order 58213 not foundetOrder 61007 not foundsont la même erreur, donc les nombres, URL, e-mails et identifiants deviennent des marqueurs ;les premières frames de votre propre code, par fichier et fonction plutôt que par ligne, pour qu'une modification sans rapport plus haut dans le fichier ne scinde pas le groupe.
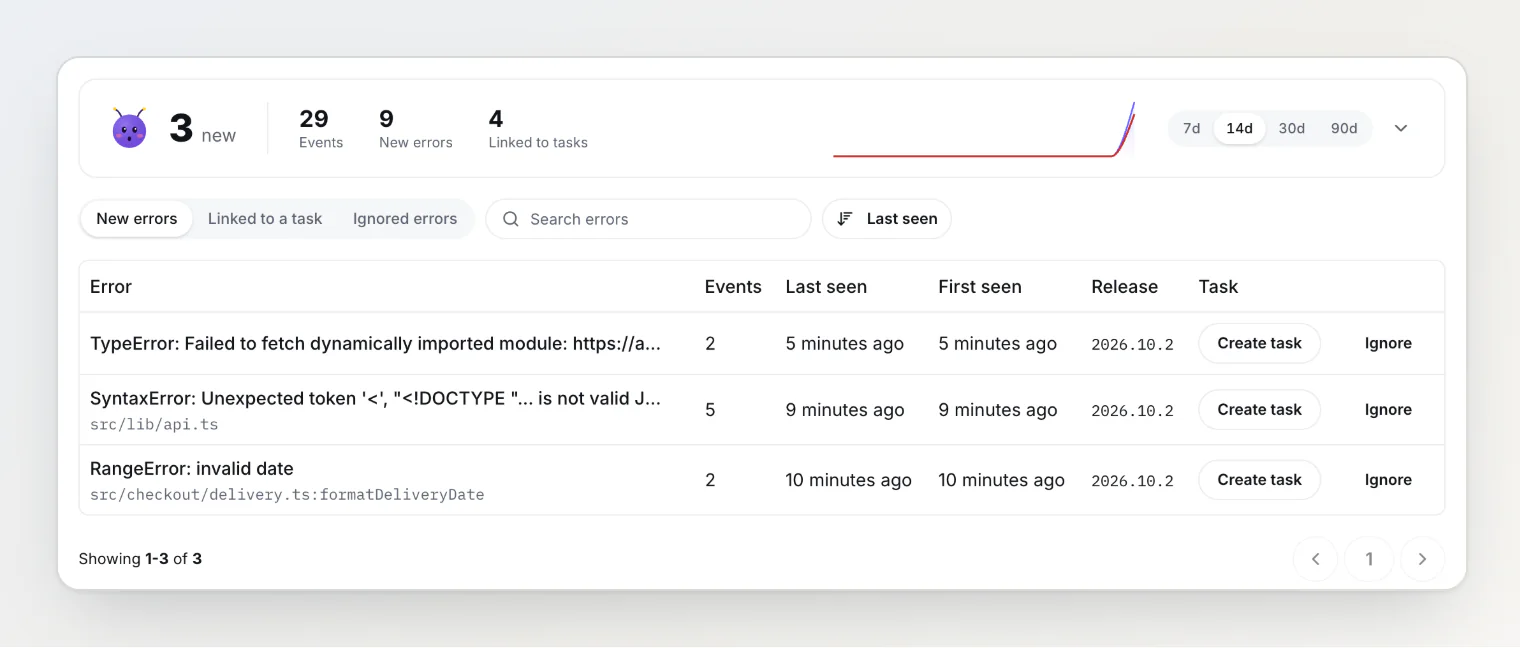
C'est bien, pas parfait. Les navigateurs formulent le même échec différemment : Chrome dit Cannot read properties of undefined (reading 'total'), Safari dit undefined is not an object (evaluating 'cart.summary.total'). Ils construisent aussi les piles différemment ; Firefox ajoute une frame pour l'endroit où un callback a été enregistré. De temps en temps, un même bug apparaît donc comme deux erreurs, une par navigateur. Un outil devrait vous laisser rattacher les deux à la même tâche et passer à autre chose, au lieu de faire comme si cela n'arrivait jamais.
3. Le bruit : ce qu'il faut jeter d'abord
Certaines erreurs ne sont pas les vôtres, et certaines ne sont pas vraiment des erreurs. Écartez-les avant qu'elles n'atteignent votre liste, sinon la liste ne vaut plus la peine d'être lue.
Ce que vous voyez | Pourquoi ça arrive | Que faire |
|---|---|---|
| un script d'une autre origine, masqué par le navigateur | l'écarter, ou ajouter |
une frame dans | une extension du navigateur a injecté du code dans votre page | l'écarter |
| une boucle de mise en page sans conséquence, signalée par le navigateur | l'écarter |
| un bloqueur de pub a retiré un script d'analytics que votre code appelle encore | l'ignorer, ou protéger l'appel |
| une requête annulée par votre propre code | l'ignorer |
Deux règles de plus gardent le volume raisonnable sans rien perdre :
Envoyez chaque erreur distincte une fois par session. Un crash dans une boucle de rendu peut se déclencher des centaines de fois par seconde dans un onglet. La première occurrence vous dit tout.
Plafonnez le débit par page. Dix par minute, c'est largement assez pour un onglet. Au-delà, c'est une boucle, pas une information nouvelle.
L'échantillonnage, qui n'envoie qu'une partie des erreurs, aide une fois que le trafic est assez gros pour que 10 % de ce trafic trouve encore chaque bug. Sur une petite app, il cache surtout l'erreur rare que vous aviez le plus besoin de voir. Laissez-le à 100 % tant que le compte mensuel ne dit pas le contraire.
4. Des stack traces lisibles sans publier votre code source
Le code de production est minifié, donc une stack trace brute ressemble à ceci :
TypeError: Cannot read properties of undefined (reading 'subtotal')
    at T (https://acme-store.com/assets/app-L5L4OHQM.js:2:1095)
    at x (https://acme-store.com/assets/app-L5L4OHQM.js:2:2081)
Une source map la retraduit en renderCartSummary dans src/cart/cart-summary.ts, ligne 6. Le problème, c'est l'endroit où vivent les maps. Les servir à côté de votre JavaScript fonctionne pour les DevTools, et publie aussi votre code source pour quiconque ouvre l'onglet réseau.
La meilleure approche, ce sont les source maps cachées (hidden). Le bundler écrit les fichiers .map sans que votre JavaScript pointe vers eux, votre CI les envoie au tracker d'erreurs, et elles n'atteignent jamais votre serveur.
Le tracker doit ensuite trouver la bonne map pour chaque frame. Les faire correspondre par URL de fichier et nom de version, c'est l'ancienne méthode, et elle casse facilement : un CDN change l'URL, un nom de version ne correspond pas, deux builds partagent un nom. La méthode plus fiable, vers laquelle Sentry est passé et que j'utilise aussi, c'est un debug ID. Une étape après le build calcule un identifiant à partir du contenu de chaque fichier et l'inscrit dans le fichier et dans sa map. À l'exécution, le fichier enregistre son ID, l'erreur le transporte, et la map est retrouvée par l'ID seul.
En pratique, ce sont trois commandes :
vite build --sourcemap hidden
npx @bugdump/cli sourcemaps inject dist
npx @bugdump/cli sourcemaps upload dist --release "$GIT_SHA" --delete-after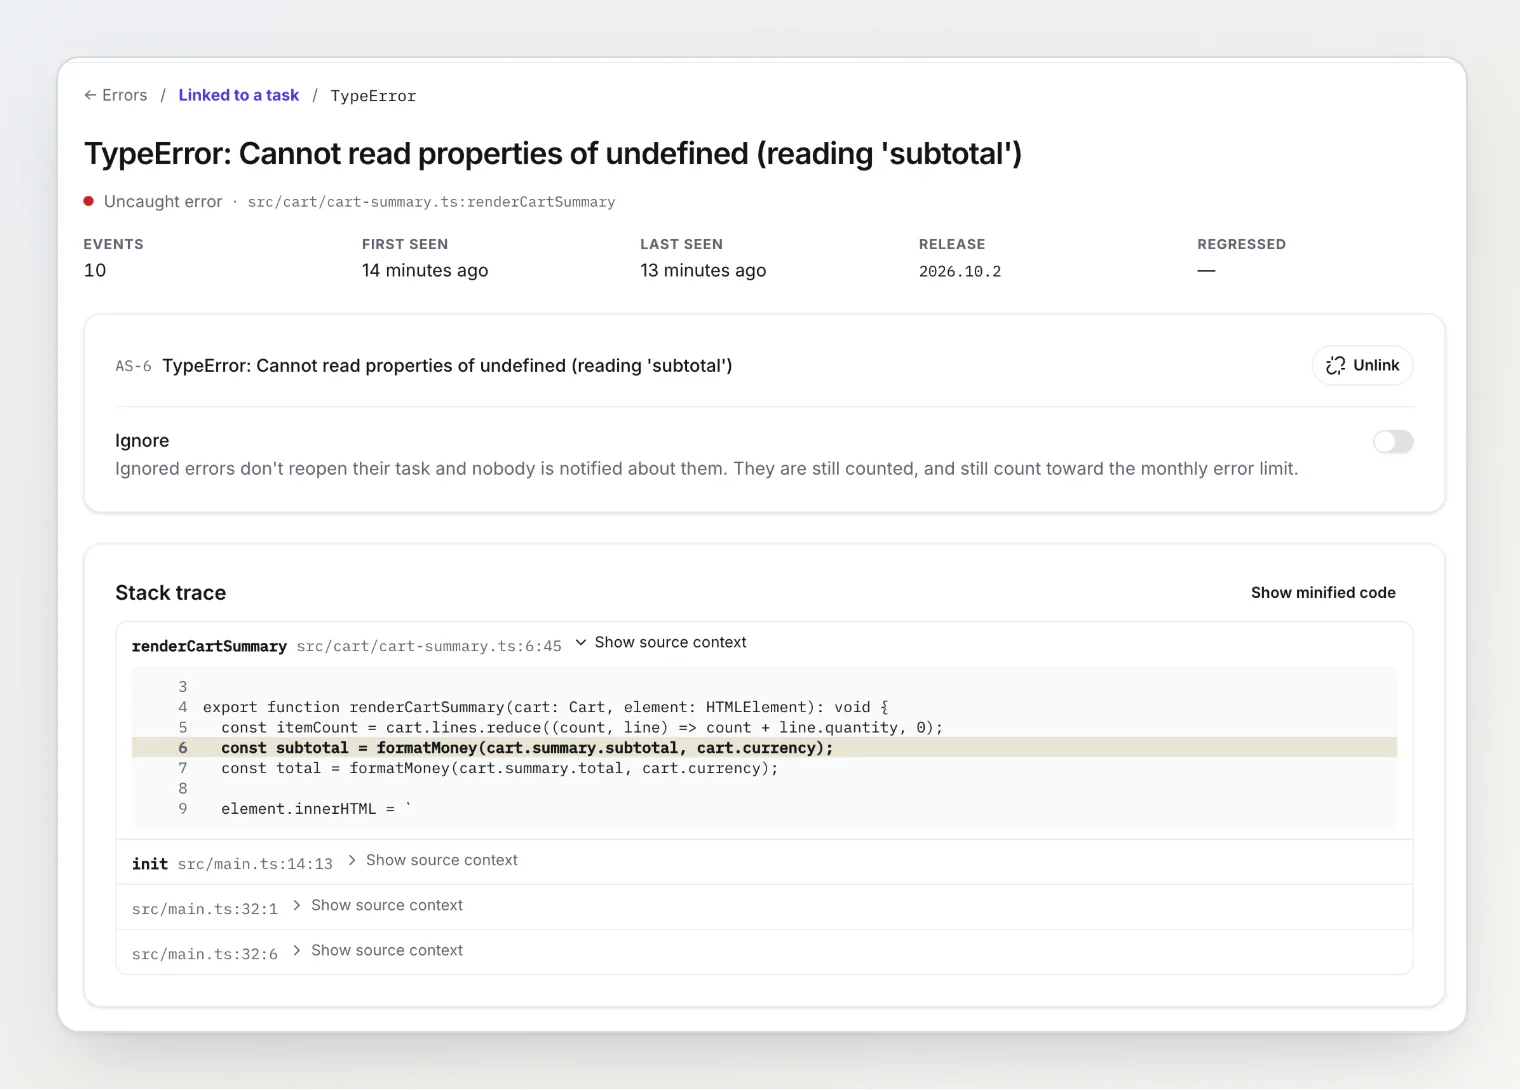
5. La minute qui précède l'erreur
Une stack trace vous dit où le code a abandonné. Souvent, elle ne vous dit pas pourquoi.
Voici un exemple tiré de ma boutique de démo. L'erreur est SyntaxError: Unexpected token '<', "<!DOCTYPE "... is not valid JSON, levée dans un petit helper getJson(). La pile pointe vers JSON.parse, ce qui est exact et ne sert à rien. Le journal réseau du même événement l'explique : GET /api/recommendations est revenu sous la forme d'une page 502 du load balancer, et le code a essayé de parser ce HTML comme du JSON.
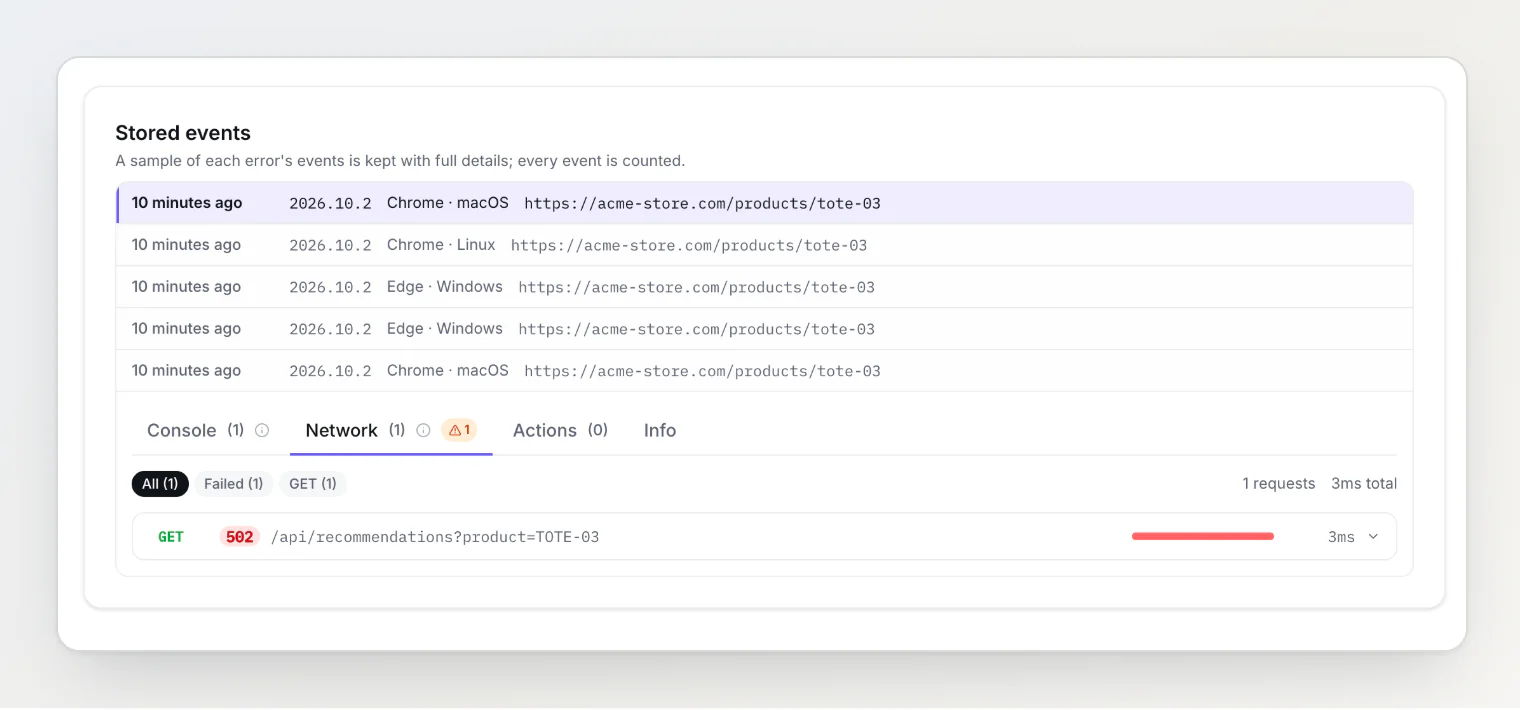
C'est pourquoi un événement d'erreur devrait transporter la dernière minute de logs de console, de requêtes réseau et de clics, les mêmes éléments qu'un bon rapport de bug. Sans eux, la moitié de vos erreurs finissent en « impossible à reproduire ».
L'autre moitié du contexte, ce sont vos utilisateurs. Dans la même boutique de démo, la tâche AS-1 a été rédigée à partir de plaintes de clients : « Checkout button does nothing on Safari ». Telle quelle, c'est le rapport classique dont personne ne peut rien faire. Sur la même tâche se trouve maintenant l'erreur capturée, vue quatre fois, uniquement dans Safari et Mobile Safari : window.requestIdleCallback is not a function. Safari n'a pas requestIdleCallback, donc le gestionnaire de clic lève une exception avant même que la commande soit envoyée. Ce que les clients ont vu et la ligne qui l'explique sont sur la même carte.
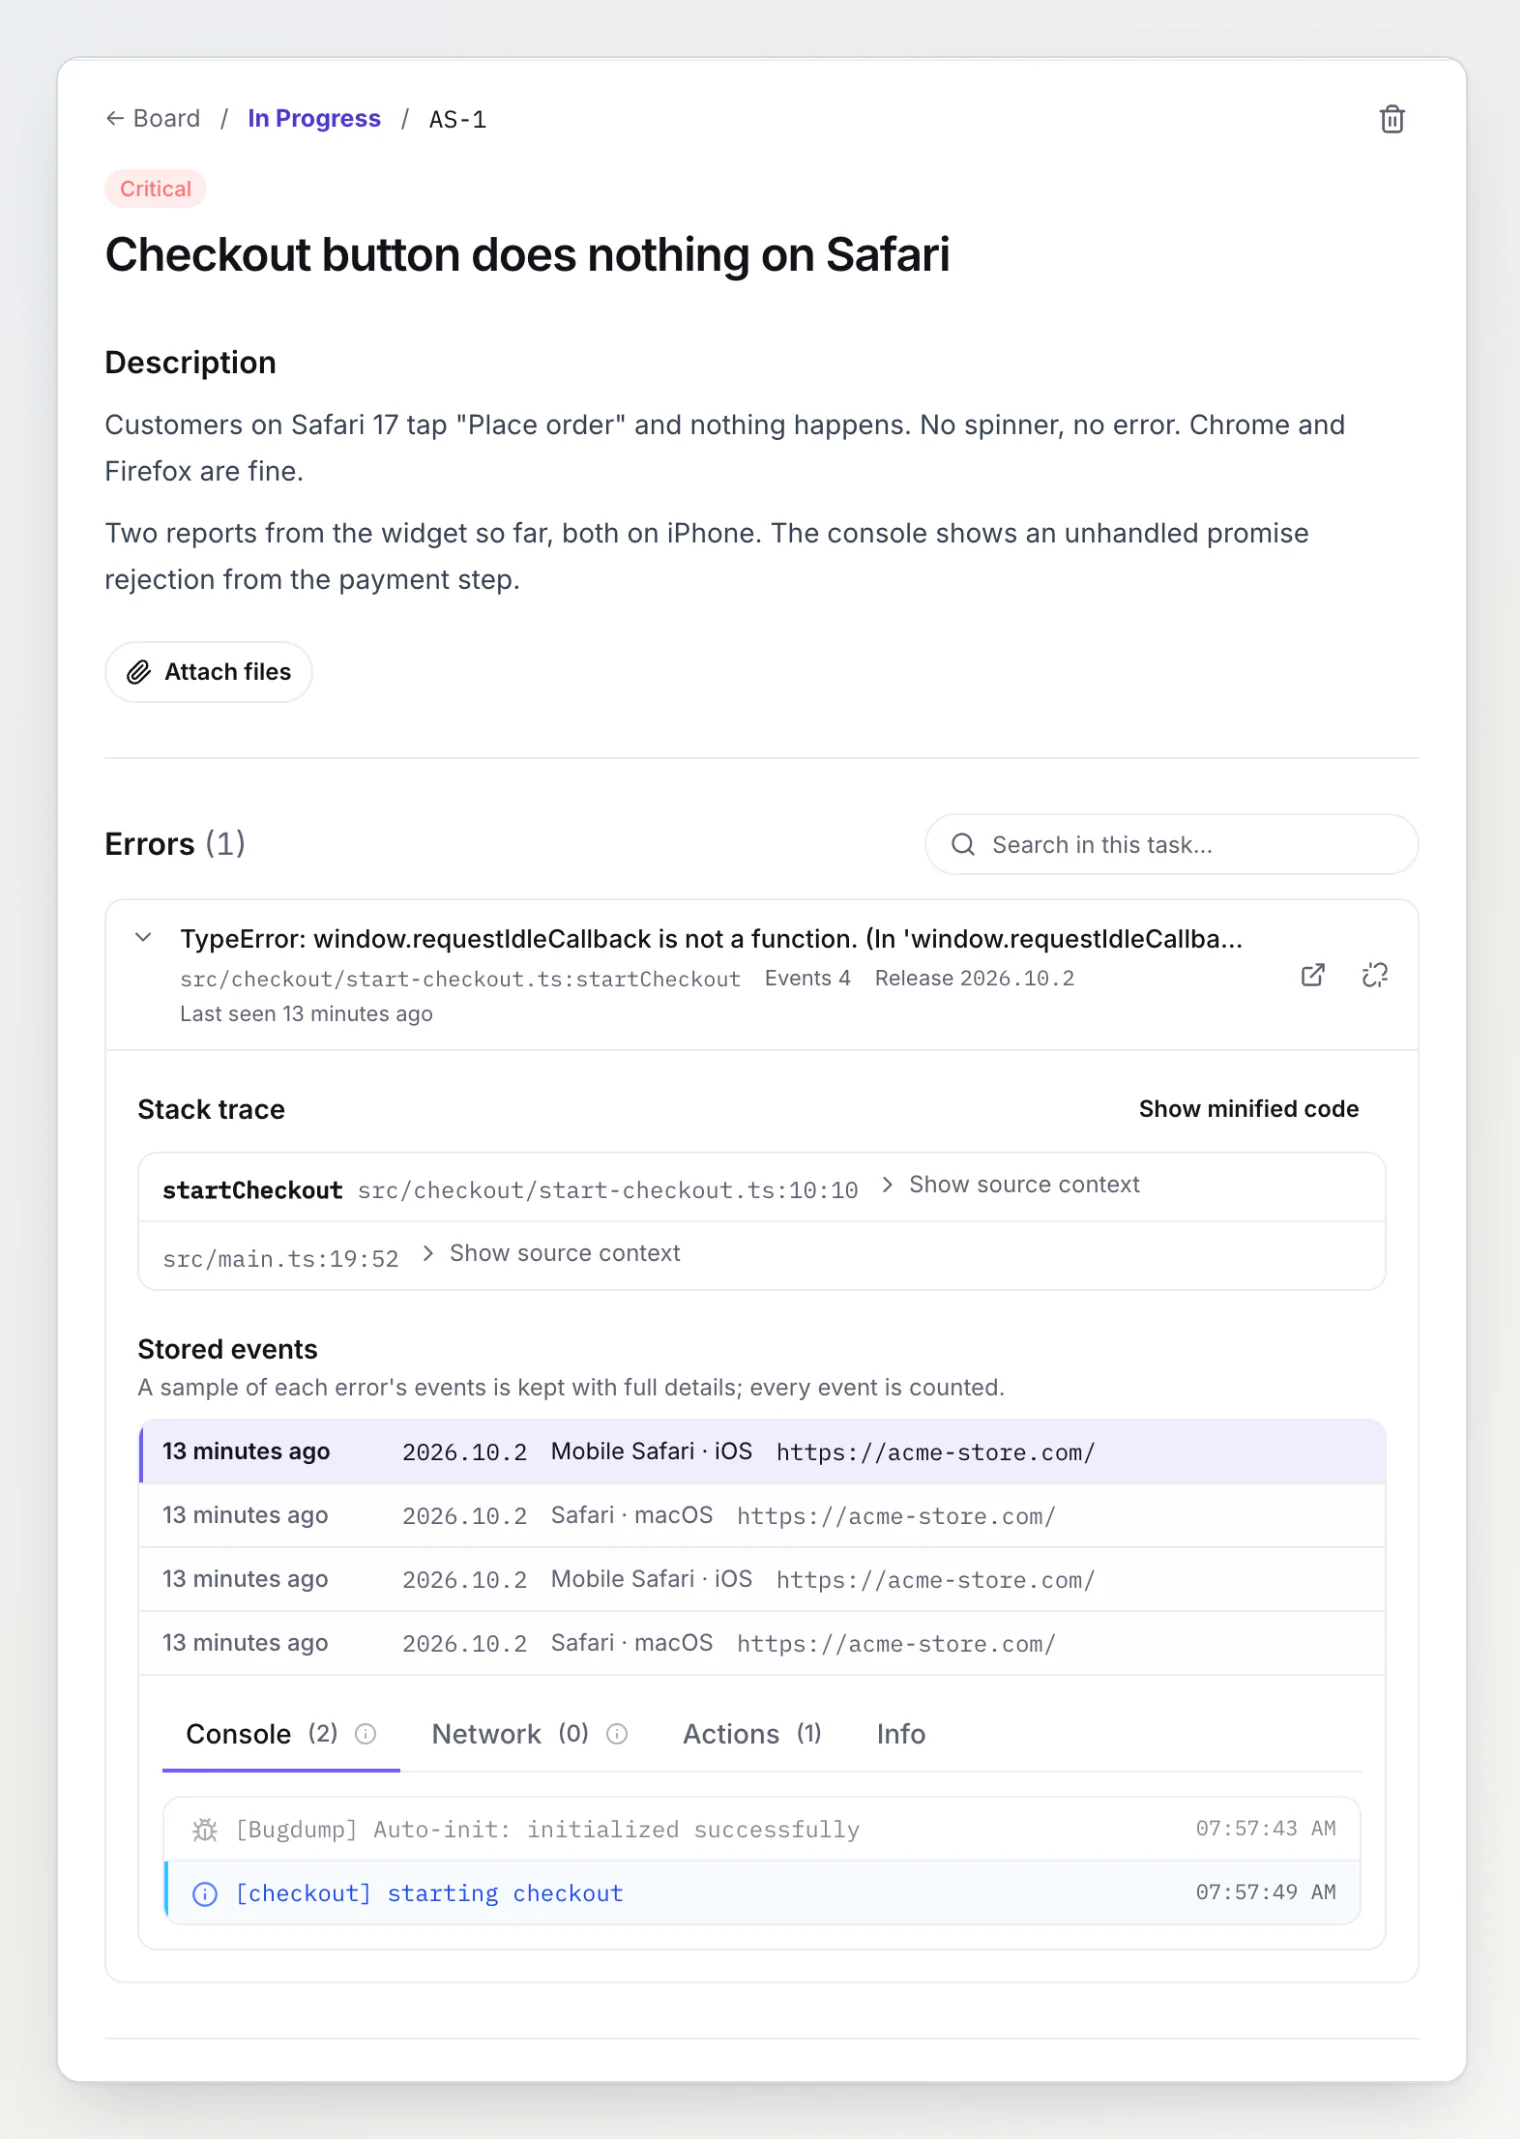
C'est ce qui échappe à un tableau de bord d'erreurs séparé. Le bug qu'un utilisateur décrit et l'erreur que le code lève sont souvent le même bug, et ils ont leur place au même endroit.
Avez-vous besoin d'un outil de monitoring complet ?
Pas toujours. Les produits dédiés au monitoring d'erreurs font bien plus que capter les erreurs du navigateur, et si vous avez besoin de ce qu'ils apportent, utilisez-en un. Pour une petite app, la comparaison honnête ressemble à ceci :
Capture d'erreurs dans votre bug tracker | Un outil de monitoring dédié | |
|---|---|---|
Ce qu'il capte | les erreurs et rejets JavaScript dans le navigateur | les erreurs navigateur, serveur et mobile, plus la performance |
Où vont les erreurs | sur le même tableau que les rapports de bug de vos utilisateurs | dans une boîte de réception séparée, avec un lien vers votre tracker |
Mise en place | le widget que vous avez déjà | un second SDK, un projet et un jeu d'alertes |
Alertes | une notification pour les erreurs nouvelles et celles qui reviennent | règles, seuils et routage d'astreinte |
Pour qui | petites apps web, quelques développeurs | équipes avec astreinte, plusieurs services et des SLO |
Si votre app se compose d'un frontend et d'une API, et que les deux ou trois mêmes personnes lisent les rapports de bug et corrigent les erreurs, un seul tableau, c'est moins à configurer et moins à consulter. Dès que vous avez un backend à surveiller, une astreinte ou un budget de performance, un outil dédié mérite sa place.
Une checklist pour une petite app
Écoutez à la fois
erroretunhandledrejection, et chargez le tracker tôt.Signalez les erreurs que vous interceptez vous-même, quand elles vous intéressent encore.
Définissez une version (
release) à chaque build, pour distinguer un nouveau bug d'un vieil onglet.Buildez avec des source maps cachées et envoyez-les depuis la CI. Ne déployez jamais les maps.
Écartez à la source les erreurs d'extensions,
Script error.et les avertissements inoffensifs du navigateur.Envoyez chaque erreur une fois par session, et laissez l'échantillonnage désactivé tant que le volume ne l'exige pas.
Transformez les erreurs en tâches à côté de vos rapports de bug, pas en une seconde boîte de réception que personne n'ouvre.
FAQ
Le suivi des erreurs ralentit-il mon site ? Pas d'une façon que vous pourriez mesurer. Les deux listeners ne font rien tant que rien n'échoue, et un tracker raisonnable envoie chaque erreur distincte une fois par session, en arrière-plan.
Que signifie « Script error. » ? Une erreur s'est produite dans un script d'une autre origine et le navigateur en a masqué les détails. Ajoutez crossorigin="anonymous" à cette balise script et faites envoyer Access-Control-Allow-Origin par son serveur, ou écartez ces erreurs : sans détails, il n'y a rien à faire.
Est-ce sûr d'envoyer les source maps ? Les envoyer à votre tracker d'erreurs, oui. C'est les servir publiquement qui expose votre code source. Buildez des maps cachées, envoyez-les et supprimez-les avant le déploiement.
Combien d'erreurs une petite app va-t-elle envoyer ? Cela dépend bien plus du nombre de bugs distincts que du trafic. Avec chaque erreur envoyée une fois par session, une page qui a un bug envoie un événement par visite touchée, pas un par crash.
L'essayer dans BugDump
La capture d'erreurs fait partie du widget BugDump, sur tous les forfaits, et elle est activée par défaut. Le forfait Gratuit inclut 1 000 événements d'erreur par mois et par projet. Commencez par Capturer les erreurs JavaScript automatiquement, puis Des stack traces lisibles : envoyer les source maps et Travailler avec les erreurs capturées.
Pour aller plus loin
La relecture de session pour voir ce que l'utilisateur a fait avant le bug — ce que la relecture d'une session montre et qu'une stack trace ne montre pas.
Un bug tracker léger pour les petites équipes, quand Jira est de trop — à quoi ressemble un bug tracker à la taille d'une équipe de quelques personnes.
Comment capturer les logs console et les requêtes réseau d'un utilisateur — comment récupérer la console et le réseau de la minute qui précède un bug.