Para una app web pequeña, el seguimiento de errores de JavaScript se reduce a cuatro cosas: registrar cada excepción no capturada y cada promesa rechazada que nadie maneja, agrupar las repeticiones para que cien fallos se lean como un solo bug, convertir los stack traces minificados de vuelta en tu propio código y conservar la actividad de la consola y de la red del minuto anterior. Los dashboards, las reglas de alertas y el tracing de rendimiento pueden esperar hasta que vigilarlos sea el trabajo de alguien.
Aquí repaso las cuatro, los detalles del navegador detrás de cada una y el ruido que puedes descartar. Acabo de lanzar la captura de errores en BugDump, así que los ejemplos salen de ahí, pero la mecánica es la misma con cualquier herramienta.
Tus usuarios no te lo van a decir
Cuando el botón de pagar no hace nada, la mayoría lo intenta otra vez, suspira y se va. Unos pocos escriben, normalmente días después, con una descripción como «en mi teléfono no funciona». El error estuvo ahí todo el tiempo, en una consola que nadie miraba.
Ese es el argumento a favor del seguimiento de errores en una frase: convierte los bugs que nadie reporta en una lista que puedes ir resolviendo. En una app pequeña, la lista importa más que cualquier gráfico que se dibuje encima.
1. Capturar errores: dos eventos
Los navegadores informan de los fallos a través de dos eventos, y necesitas los dos:
window.addEventListener('error', (event) => {
  report(event.error ?? new Error(event.message));
});

window.addEventListener('unhandledrejection', (event) => {
  report(event.reason);
});
error se dispara con una excepción que nada capturó: una errata, leer una propiedad de undefined, llamar a una función que no existe. unhandledrejection salta cuando una promesa falla sin que nadie la escuche. En código que es casi todo async y await, ese segundo evento es donde acaban la mayoría de los errores. Un fetch que recibe una página de error en HTML y llama a response.json() sobre ella nunca pasa por window.onerror.
Tres cosas que estos eventos no te dan:
Los errores que capturas tú mismo. Un
try/catchque muestra un mensaje amable también oculta el error a los dos eventos. Si aun así quieres enterarte, repórtalo desde el bloquecatch.Los detalles de errores de otros orígenes. Un script de otro dominio, cargado sin CORS, falla como
Script error.sin archivo, línea ni stack. El navegador lo oculta a propósito. Carga el script concrossorigin="anonymous"y sírvelo con una cabeceraAccess-Control-Allow-Origin, o acepta que no puedes ver lo que pasa dentro.Los errores anteriores a que cargue tu tracker. Si el script de seguimiento carga el último, los fallos durante el arranque se pierden. Cárgalo pronto.
Los listeners son la parte fácil. El resto del artículo trata de lo que pasa después de report().
2. Agrupar: mil eventos, un bug
Un error que afecta a todos los visitantes de una página llega miles de veces. Lo que quieres es una fila con un contador, así que la agrupación decide si la lista sirve para algo.
El enfoque habitual, que es también el que uso yo, construye una huella (fingerprint) a partir de tres partes:
el tipo de error, como
TypeError;el mensaje sin sus partes variables:
Order 58213 not foundyOrder 61007 not foundson el mismo error, así que los números, URLs, emails e IDs se sustituyen por marcadores;los primeros frames de tu propio código, por archivo y función y no por línea, para que un cambio sin relación más arriba en el archivo no parta el grupo.
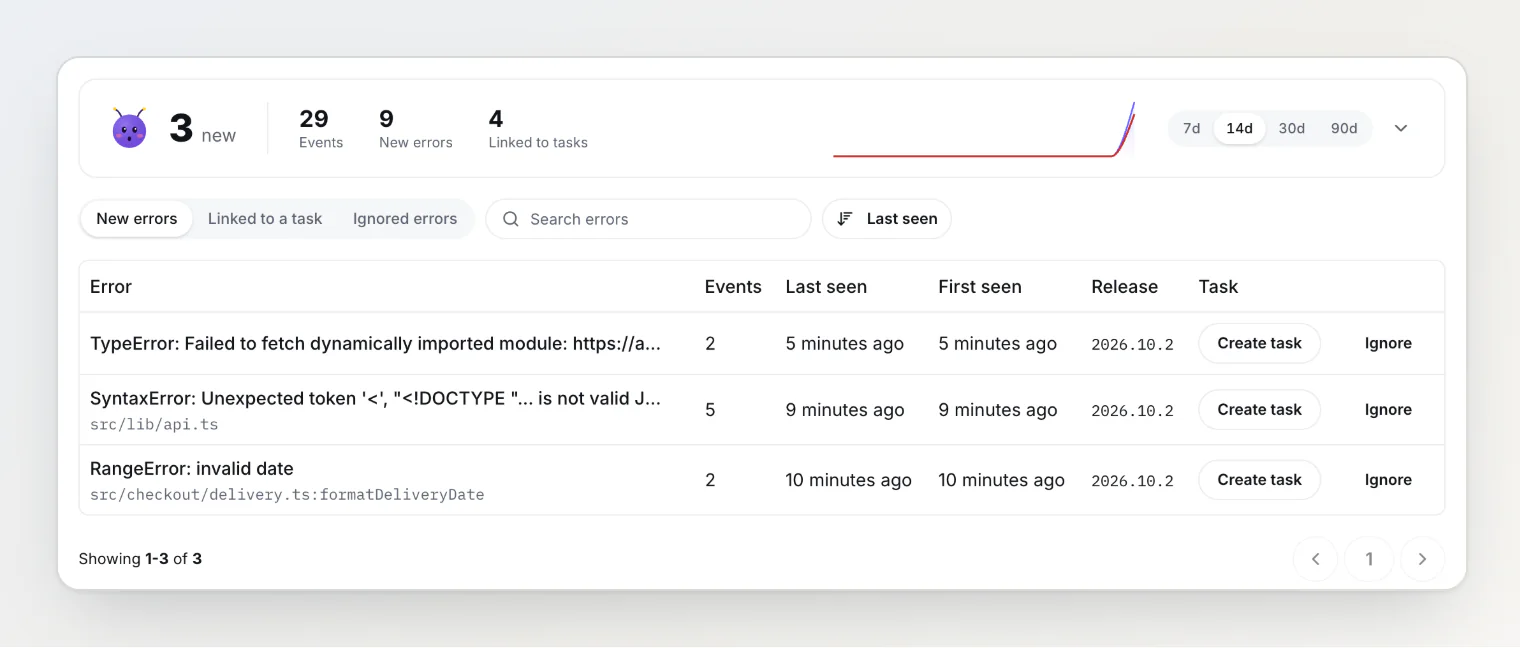
Funciona bien, pero no es perfecto. Los navegadores redactan el mismo fallo de forma distinta: Chrome dice Cannot read properties of undefined (reading 'total'), Safari dice undefined is not an object (evaluating 'cart.summary.total'). También construyen los stacks de otra manera; Firefox añade un frame para el lugar donde se registró un callback. Así que de vez en cuando un bug llega como dos errores, uno por navegador. Una herramienta debería dejarte vincular los dos a la misma tarea y seguir adelante, en vez de fingir que eso nunca pasa.
3. Ruido: qué descartar primero
Algunos errores no son tuyos, y algunos ni siquiera son errores. Descártalos antes de que lleguen a tu lista, o la lista dejará de valer la pena.
Lo que ves | Por qué pasa | Qué hacer |
|---|---|---|
| un script de otro origen, oculto por el navegador | descártalo, o añade |
un frame en | una extensión del navegador inyectó código en tu página | descártalo |
| un bucle de layout inofensivo sobre el que avisa el navegador | descártalo |
| un bloqueador de anuncios quitó un script de analítica al que tu código sigue llamando | ignóralo, o protege la llamada |
| una petición que canceló tu propio código | ignóralo |
Dos reglas más mantienen el volumen razonable sin perder nada:
Envía cada error distinto una vez por sesión. Un fallo dentro de un bucle de renderizado puede dispararse cientos de veces por segundo en una pestaña. El primero ya te lo dice todo.
Limita la frecuencia por página. Diez por minuto bastan para una pestaña. Lo que pase de ahí es un bucle, no información nueva.
El muestreo (sampling), enviar solo una parte de los errores, ayuda cuando el tráfico es tan grande que el 10 % basta para encontrar todos los bugs. En una app pequeña, sobre todo oculta justo el error raro que más necesitabas ver. Déjalo en el 100 % hasta que el recuento mensual diga lo contrario.
4. Stack traces legibles sin publicar tu código fuente
El código de producción está minificado, así que un stack trace en bruto se ve así:
TypeError: Cannot read properties of undefined (reading 'subtotal')
    at T (https://acme-store.com/assets/app-L5L4OHQM.js:2:1095)
    at x (https://acme-store.com/assets/app-L5L4OHQM.js:2:2081)
Un source map lo convierte de nuevo en renderCartSummary en src/cart/cart-summary.ts, línea 6. El problema es dónde viven los mapas. Servirlos junto a tu JavaScript funciona para las DevTools, y también publica tu código fuente para cualquiera que abra la pestaña de red.
Lo mejor son los source maps ocultos (hidden). El bundler escribe los archivos .map sin que tu JavaScript apunte a ellos, tu CI los sube al tracker de errores y nunca llegan a tu servidor.
Después, el tracker tiene que encontrar el mapa correcto para cada frame. Emparejar por URL del archivo y nombre de release es la forma antigua, y se rompe con facilidad: un CDN cambia la URL, un nombre de release no coincide, dos builds comparten nombre. La forma más fiable, a la que se pasó Sentry y que uso yo también, es un debug ID. Un paso después del build calcula un ID a partir del contenido de cada archivo y lo graba en el archivo y en su mapa. En tiempo de ejecución, el archivo registra su ID, el error lo lleva consigo y el mapa se encuentra solo por el ID.
En la práctica son tres comandos:
vite build --sourcemap hidden
npx @bugdump/cli sourcemaps inject dist
npx @bugdump/cli sourcemaps upload dist --release "$GIT_SHA" --delete-after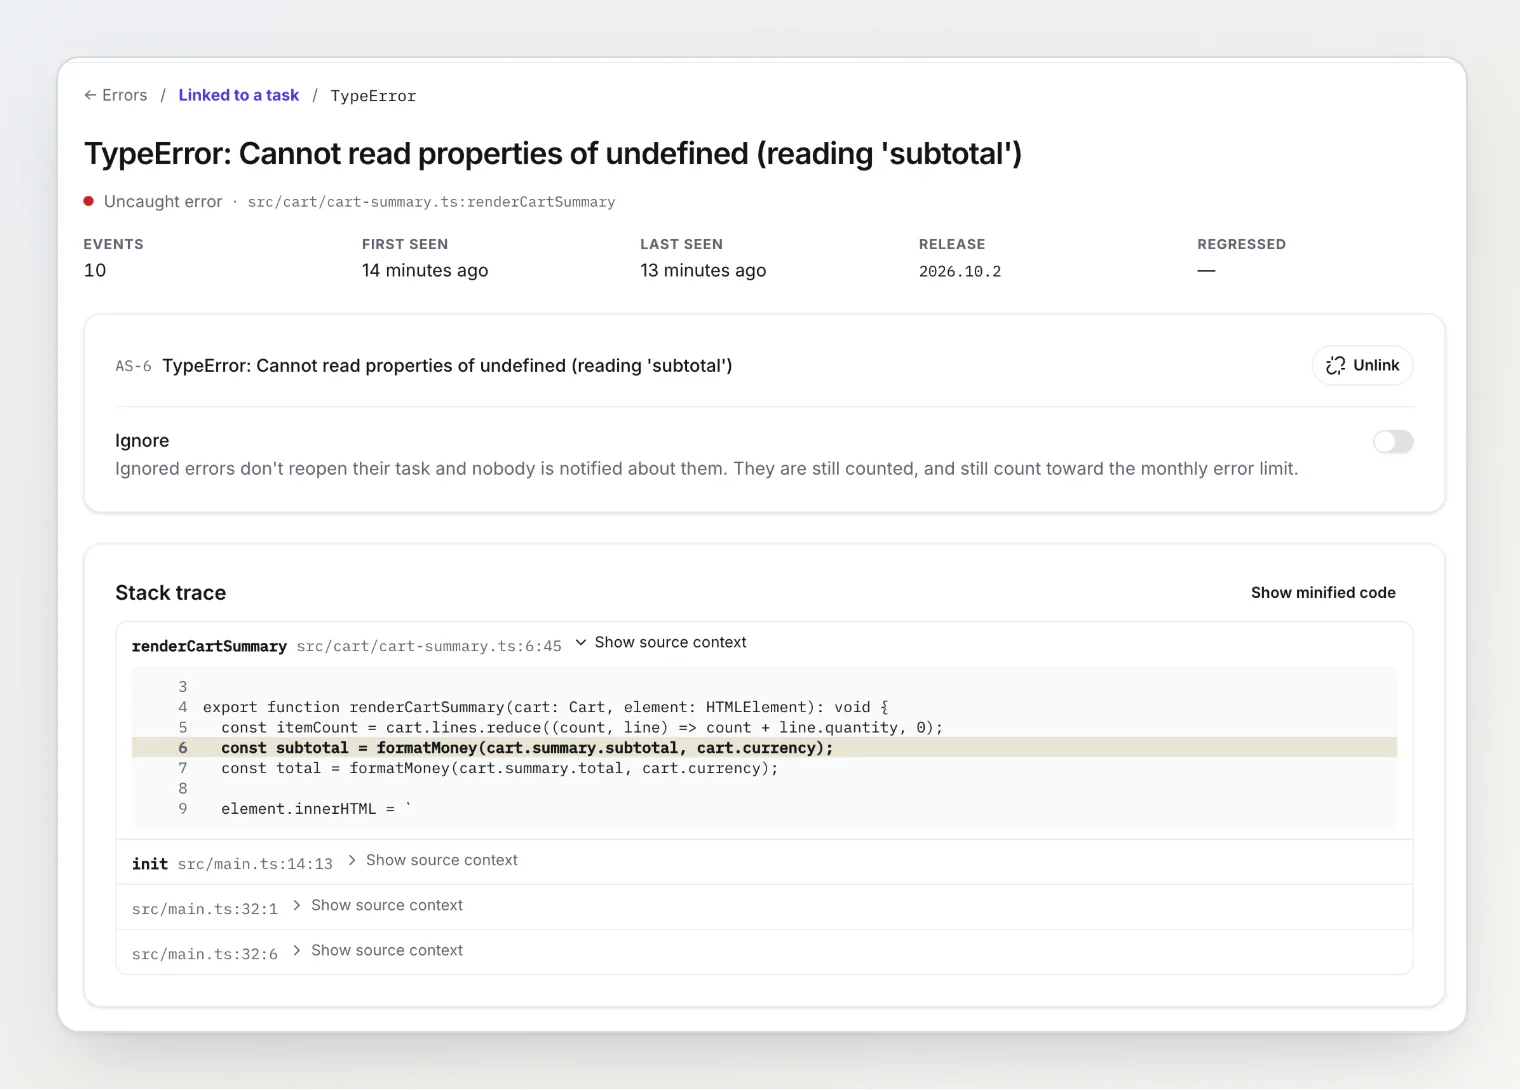
5. El minuto antes del error
Un stack trace te dice dónde se rindió el código. A menudo no te dice por qué.
Un ejemplo de la tienda de demostración. El error es SyntaxError: Unexpected token '<', "<!DOCTYPE "... is not valid JSON, lanzado dentro de un pequeño helper getJson(). El stack apunta a JSON.parse, lo cual es correcto y no ayuda en nada. El registro de red del mismo evento lo explica: GET /api/recommendations volvió como una página 502 del balanceador de carga, y el código intentó parsear el HTML como JSON.
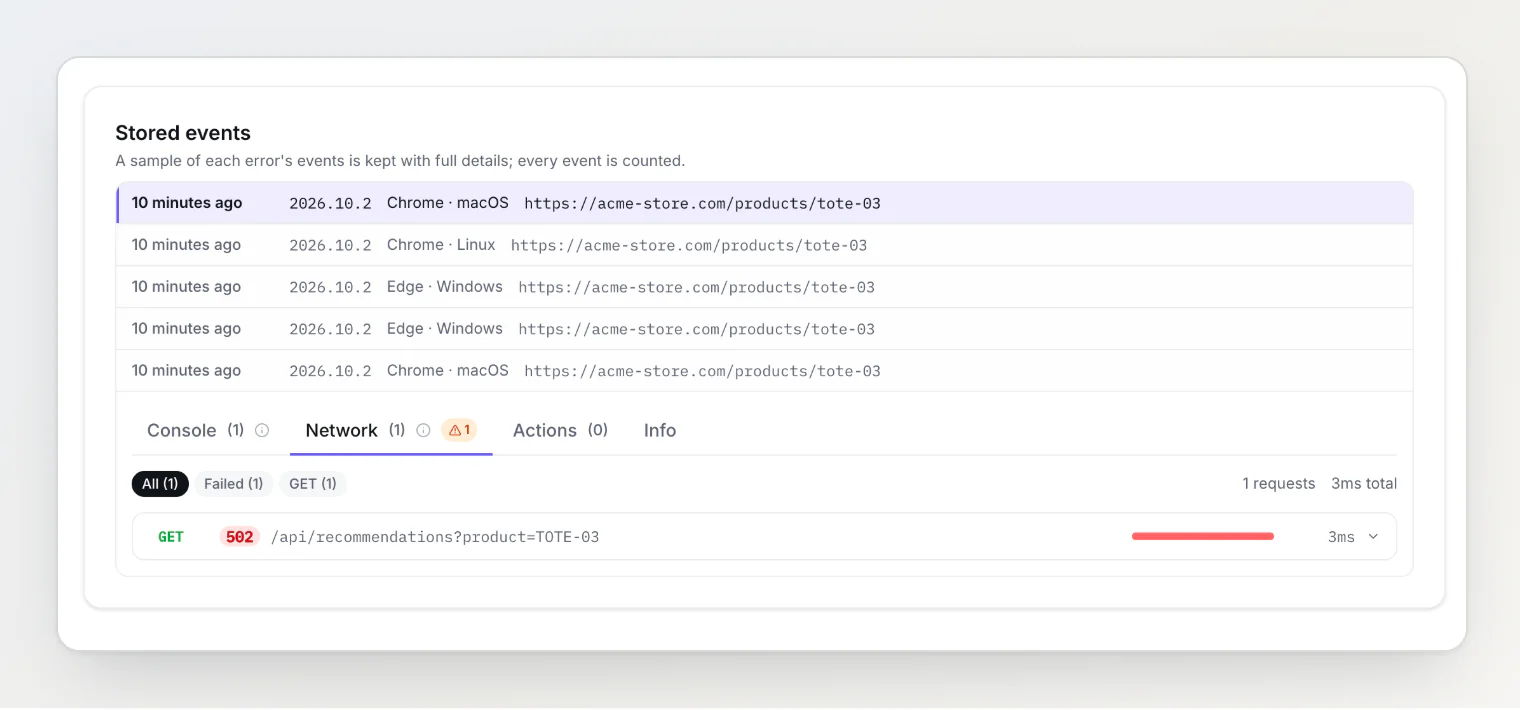
Por eso un evento de error debería llevar el último minuto de logs de consola, peticiones de red y clics: las mismas pruebas que tiene un buen reporte de bug. Sin eso, la mitad de tus errores acaban como «no se puede reproducir».
La otra mitad del contexto son tus usuarios. En la misma tienda de demostración, la tarea AS-1 se escribió a partir de quejas de clientes: «Checkout button does nothing on Safari» (el botón de pagar no hace nada en Safari). Por sí solo, es el típico reporte con el que nadie puede hacer nada. En esa misma tarea está ahora el error capturado, visto cuatro veces, solo en Safari y Mobile Safari: window.requestIdleCallback is not a function. Safari no tiene requestIdleCallback, así que el handler del clic lanza una excepción antes de que el pedido llegue a enviarse. Lo que vieron los clientes y la línea que lo explica están en una misma tarjeta.
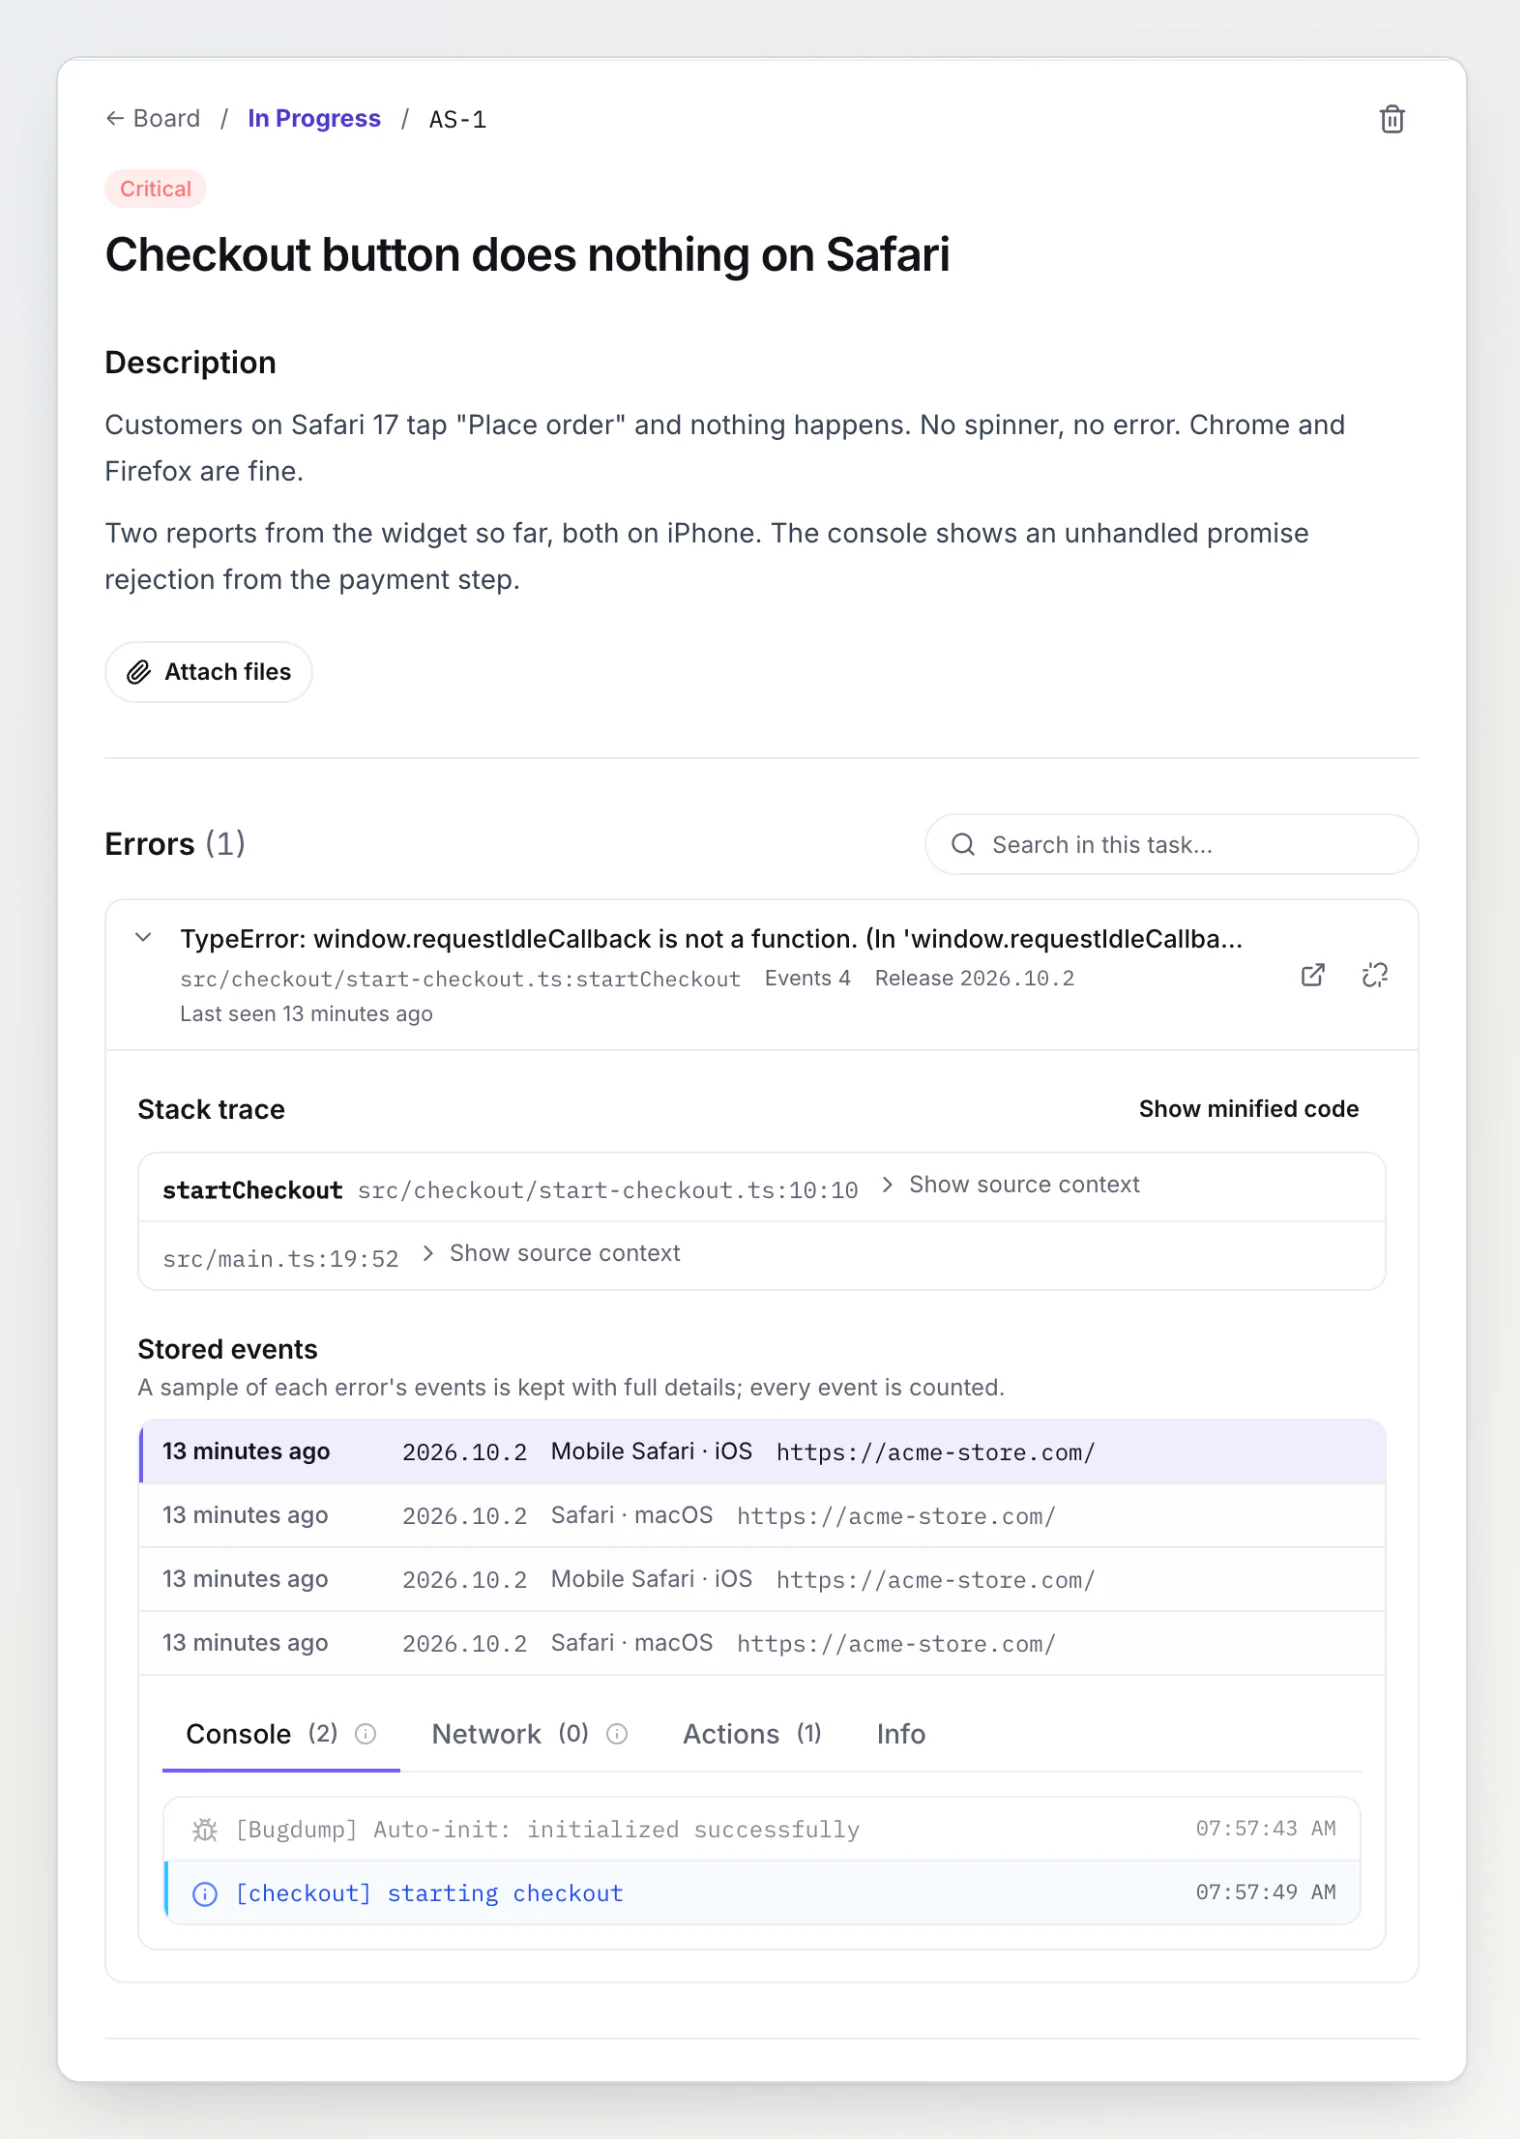
Esta es la parte que se pierde un dashboard de errores separado. El bug que describe un usuario y el error que lanza el código suelen ser el mismo bug, y deberían estar en el mismo sitio.
¿Necesitas una herramienta de monitoreo completa?
No siempre. Los productos dedicados al monitoreo de errores hacen mucho más que capturar errores del navegador, y si necesitas lo que aportan, usa uno. Para una app pequeña, la comparación honesta queda así:
Captura de errores en tu bug tracker | Una herramienta de monitoreo dedicada | |
|---|---|---|
Qué captura | errores de JavaScript y promesas rechazadas en el navegador | errores de navegador, servidor y apps móviles, además del rendimiento |
Adónde van los errores | al mismo tablero que los reportes de bugs de tus usuarios | a una bandeja aparte, enlazada con tu tracker |
Configuración | el widget que ya tienes | un segundo SDK, otro proyecto y otro conjunto de alertas |
Alertas | una notificación por errores nuevos y por los que vuelven | reglas, umbrales y rotación de guardias |
Encaja con | apps web pequeñas, pocos desarrolladores | equipos con guardias, varios servicios y SLOs |
Si tu app es un frontend y una API, y las mismas dos o tres personas leen los reportes de bugs y corrigen los errores, con un solo tablero hay menos que configurar y menos que revisar. Cuando tienes un backend que monitorear, una rotación de guardias o un presupuesto de rendimiento, una herramienta dedicada se gana su sitio.
Checklist para una app pequeña
Escucha tanto
errorcomounhandledrejection, y carga el tracker pronto.Reporta los errores que capturas tú mismo, si todavía te importan.
Define un
releaseen cada build, para distinguir un bug nuevo de una pestaña antigua.Compila con source maps ocultos y súbelos desde CI. Nunca despliegues los mapas.
Descarta en origen los errores de extensiones,
Script error.y los avisos inofensivos del navegador.Envía cada error una vez por sesión, y deja el muestreo desactivado hasta que el volumen lo exija.
Convierte los errores en tareas junto a tus reportes de bugs, no en una segunda bandeja que nadie abre.
Preguntas frecuentes
¿El seguimiento de errores ralentiza mi sitio? No de una forma que puedas medir. Los dos listeners no hacen nada hasta que algo falla, y un tracker razonable envía cada error distinto una vez por sesión, en segundo plano.
¿Qué significa «Script error.»? Ocurrió un error en un script de otro origen y el navegador ocultó los detalles. Añade crossorigin="anonymous" a esa etiqueta script y haz que su servidor envíe Access-Control-Allow-Origin, o descarta estos errores: sin detalles no hay nada que hacer con ellos.
¿Es seguro subir los source maps? Subirlos a tu tracker de errores no tiene ningún problema. Lo que expone tu código es servirlos públicamente. Genera mapas ocultos, súbelos y bórralos antes del despliegue.
¿Cuántos errores enviará una app pequeña? Depende mucho más de cuántos bugs distintos tengas que del tráfico. Con cada error enviado una vez por sesión, una página con un bug envía un evento por visita afectada, no uno por fallo.
Probarlo en BugDump
La captura de errores forma parte del widget de BugDump, en todos los planes, y viene activada por defecto. El plan Gratis incluye 1000 eventos de error al mes por proyecto. Empieza por Capturar errores de JavaScript automáticamente, luego Stack traces legibles: subir source maps y Trabajar con errores capturados.
Te puede interesar
Repetición de sesión para depurar: mira qué hizo el usuario antes del bug — lo que muestra una repetición de sesión cuando el stack trace y los logs no bastan.
Seguimiento de bugs ligero para equipos pequeños: cuando Jira es demasiado — qué necesita de verdad de su bug tracker un equipo de dos o tres personas.
Cómo capturar logs de consola y peticiones de red del navegador del usuario — cómo se guarda el minuto anterior a un bug sin pedirle nada al usuario.