Abre cualquier bug tracker y encontrarás las mismas cuatro palabras: bajo, medio, alto, crítico. Son tan estándar que nadie las cuestiona. Y para la mayoría de los equipos también son un error, no porque cuatro sea el número equivocado, sino porque las palabras son de otro.
Una escala de prioridades es una decisión compartida, comprimida
Un campo de prioridad no está para describir el bug. Está para responder una pregunta a quien mire el tablero después: ¿trabajo en esto antes que en lo que iba a hacer?
Eso convierte cada nivel de prioridad en un acuerdo comprimido. «Crítico» significa algo concreto en tu equipo: quizá «despierta a alguien de guardia», quizá «sale en el próximo parche», quizá «paramos la release». La palabra solo funciona si todos la descomprimen igual.
Y justo por eso una escala genérica se degrada. Nadie acordó qué significa el «alto» de tu tracker, así que cada persona pone su propia definición y el campo deja de transmitir información.
Las dos preguntas que la gente confunde
La mayoría de las discusiones sobre prioridad son en realidad discusiones sobre dos preguntas distintas:
Severidad: ¿qué gravedad tiene el fallo? Un crash es grave. Un icono desalineado no.
Prioridad: ¿cuándo lo vamos a arreglar? Un icono desalineado en la página de precios una hora antes de un lanzamiento es urgente y no es grave.
Un solo campo no puede contener las dos, y los equipos que lo intentan acaban con una escala que significa severidad los lunes y prioridad los viernes. Elige una (para la mayoría de los equipos de producto, la útil es la prioridad, porque es la que cambia lo que haces a continuación) y, si de verdad necesitas las dos, haz de la severidad un campo aparte.
Cuántos niveles
Menos de los que crees.
Una escala larga no falla porque la gente elija mal, sino porque deja de elegir. Con P0 a P4, la mayoría de los equipos usan P1 y P3 y abandonan el resto sin decir nada. Tienes una escala de cinco niveles que hace el trabajo de dos.
Una prueba: para cada par de niveles contiguos, ¿puedes enunciar una regla que decida entre ellos sin pensar? Si «alto» y «medio» solo se distinguen por intuición, son un nivel con dos nombres.
Tres niveles que la gente aplica de forma coherente valen más que cinco que se adivinan. Cuatro es un punto de llegada habitual porque te da dos variantes de «pronto» y dos de «más tarde».
La otra regla es que el nivel más alto tiene que ser raro. Si un tercio del tablero es crítico, la palabra ha pasado a significar «esto me importa», y el tablero ya no te dice por dónde empezar. Un nivel superior útil describe algo por lo que interrumpirías el trabajo, y eso, por definición, no puede ser un tercio de nada.
Ponles el nombre que usa tu equipo
Si en la reunión diaria alguien pregunta «¿esto es bloqueante?», entonces Bloqueante debería ser un valor del tracker. Cada paso de traducción entre cómo habla la gente y lo que ofrece la herramienta es un punto donde el campo se rellena mal o se salta.
Este es el argumento más fuerte a favor de las prioridades editables, y no tiene nada que ver con la flexibilidad por sí misma. Es que un campo que la gente puede responder con su propio vocabulario es un campo que de verdad va a responder.
Algunas escalas que puedes robar:
Equipos que vienen de soporte: Bloqueante · Urgente · Normal · Baja, que encaja limpiamente con un SLA.
Equipos de producto: Ahora · Próximo · Más adelante, tres niveles sin ambigüedad que además sirven de hoja de ruta.
Trabajo tipo incidente: P0 · P1 · P2; si el runbook de guardias ya usa estos números, usa los mismos aquí.
Editar la escala en BugDump
BugDump empieza cada proyecto con Bajo, Medio, Alto y Crítico, y ninguno es fijo. En la página Propiedades, selecciona Prioridad y edita la lista: renombra directamente en ella, cambia colores, añade los tuyos y elimina los que no uses.
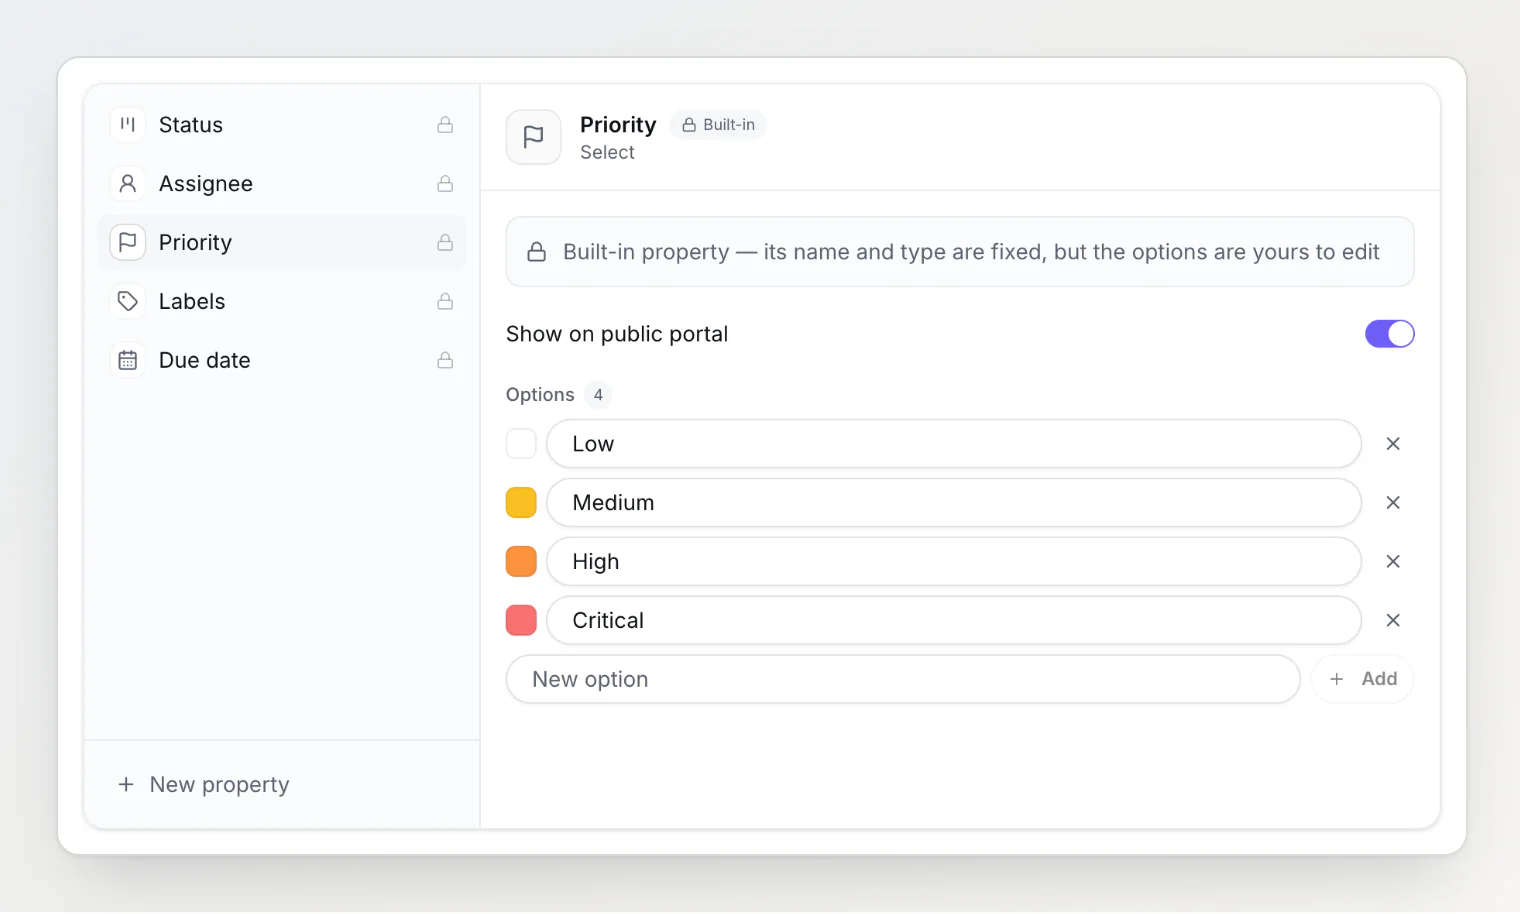
Un cambio de nombre llega a todo a la vez. Las tareas ya marcadas como Crítico muestran la palabra nueva en sus tarjetas, en el panel de la tarea, en el portal público y a través del servidor MCP. No hay migración ni reetiquetado, porque la tarea apunta a la opción en lugar de guardar una copia de su nombre.
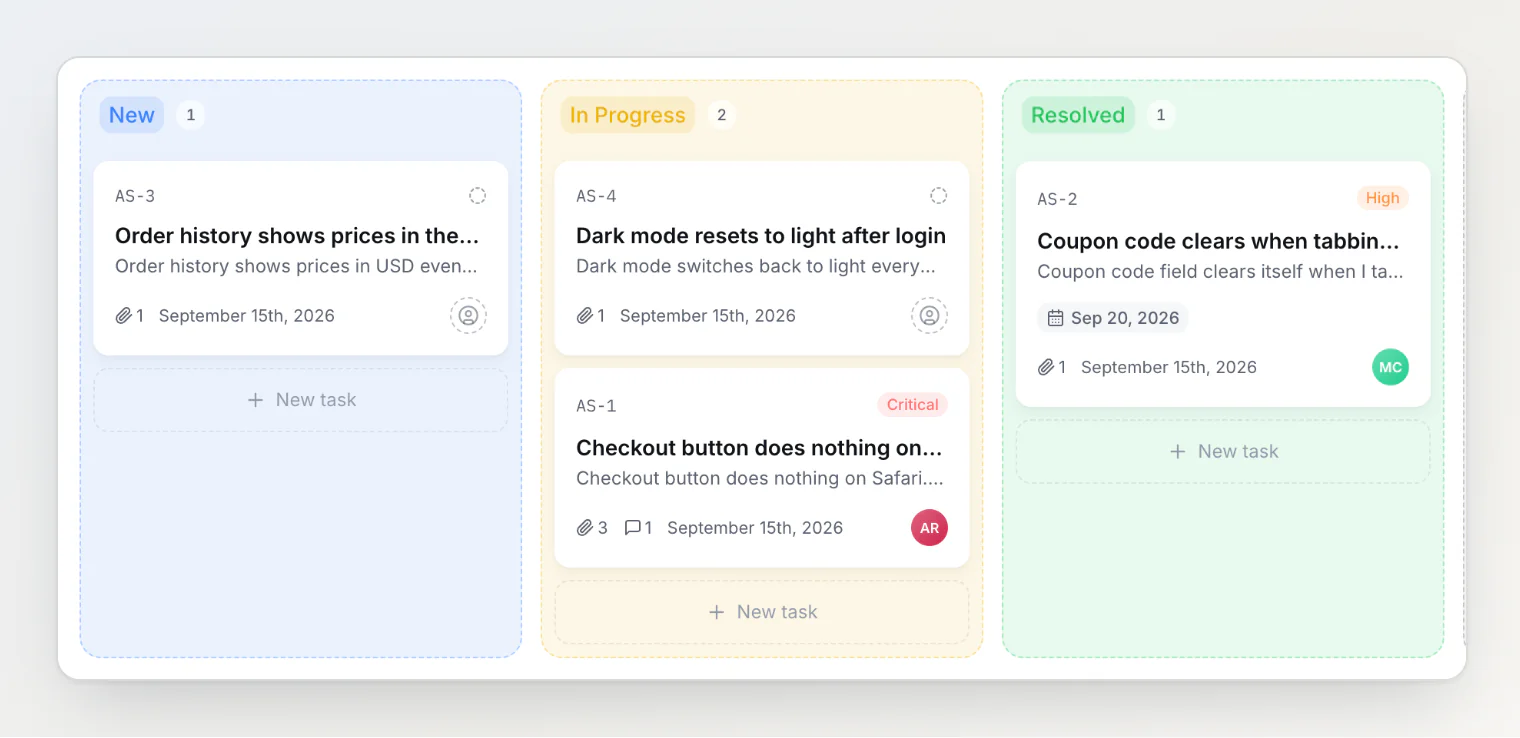
Eliminar un nivel conserva sus tareas; simplemente pierden esa prioridad. Así que podar una escala que diseñaste de más sale barato, y eso importa, porque la mayoría de los equipos solo descubren la escala correcta después de usar la equivocada durante un mes.
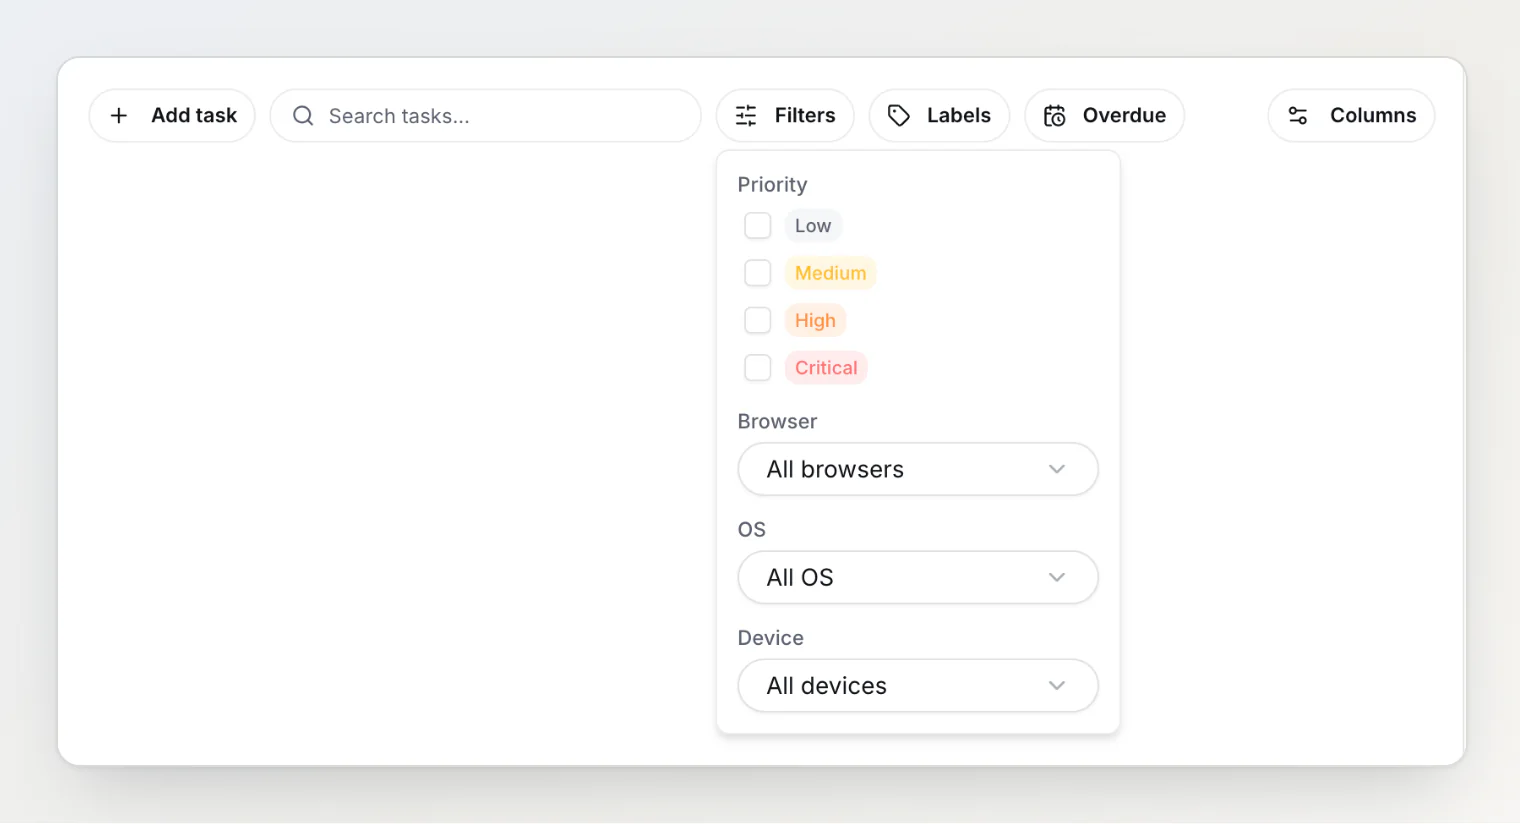
El tablero filtra por lo que tenga tu lista, por varios valores a la vez.
Dos cosas a vigilar al renombrar
Todo lo que asigna una prioridad por nombre. Un widget embebido que pasa priority: 'critical', o un script que llama a la API. La comparación ignora mayúsculas, así que critical sigue encontrando Critical, pero si renombras Crítico a Bloqueante, el nombre antiguo ya no coincide con nada. Los reportes anónimos siguen llegando, solo que sin prioridad; las llamadas autenticadas se rechazan para que te enteres.
Integraciones que traducen a sus propias severidades. Jira y Freshdesk tienen sus propias escalas, y un nivel que te has inventado no tiene equivalente, así que esos tickets reciben la severidad intermedia del destino. Si esa correspondencia importa, añade niveles en vez de renombrar los predeterminados.
El resumen honesto
La prioridad es un campo pequeño que decide el orden de todo lo demás, y solo funciona cuando un equipo se ha puesto de acuerdo de verdad en qué significa cada nivel. Un vocabulario fijo estorba ese acuerdo. Mejor que el tracker aprenda tus palabras.
Después, usa la escala con algo de disciplina: que el nivel más alto siga siendo raro, elimina el nivel que nadie elige y revísala tras un mes de bugs reales.
Te puede interesar
Métricas de bugs que de verdad importan — qué números dicen algo sobre tus bugs y cuáles solo llenan un dashboard.
Cómo hacer el triaje de bugs más rápido: un flujo de trabajo con el teclado — cómo repasar una columna entera de reportes sin soltar el teclado.
Campos personalizados en un bug tracker: qué añadir y qué evitar — la misma prueba aplicada a cualquier campo: qué decisión cambia por él.