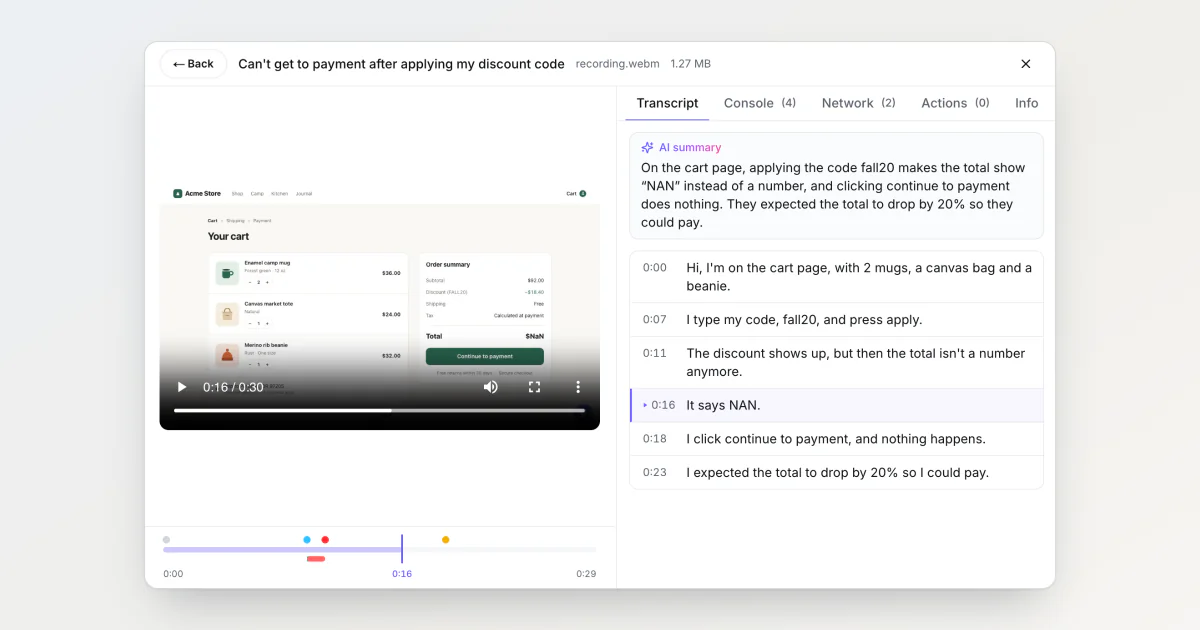
Wer einen Bug aufnimmt, redet dabei. Jemand aus der Kundschaft öffnet das Widget, startet eine Bildschirmaufnahme, klickt sich durch den Checkout und sagt: „Der Rabatt wird angezeigt, aber dann ist die Summe keine Zahl mehr.“ Bei der Person, die den Bug behebt, kam dieser Satz bisher nur an, wenn sie auf Play drückte und zuhörte.
Die Idee, ihn aufzuschreiben, kam von FluidVoice, einer Open-Source-App, die Sprache in Text umwandelt. BugDump transkribiert jetzt die Sprache in Aufnahmen aus dem Widget und fügt eine Zusammenfassung von ein bis drei Sätzen hinzu. Auf dem Weg dahin habe ich mehr darüber gelernt, was Whisper mit Stille macht, als über Sprache.
Das Mikrofon fehlte oft in der Aufnahme
Vor dem ersten Transkript habe ich nachgelesen, wie das Widget Ton aufnimmt. Das Mikrofon ließ es oft weg. Es mischte den geteilten Ton und das Mikrofon zu einer Spur, fügte diese Spur der Aufnahme aber nur hinzu, wenn das Geteilte (ein Tab, ein Fenster oder der ganze Bildschirm) eigenen Ton mitbrachte. Wer ein Fenster oder den Bildschirm teilte, in Firefox oder Safari aufnahm oder in Chrome Tab-Audio nicht angehakt hatte, sah den Mikrofon-Button leuchten, aber der Ton des Mikrofons kam nie in der Aufnahme an.
SDK 0.0.49 nimmt das Mikrofon immer auf, wenn es eingeschaltet ist, egal was geteilt wurde, und vermerkt in der Aufnahme, ob es zu irgendeinem Zeitpunkt an war. Eine Aufnahme mit ausgeschaltetem Mikrofon geht nicht in die Transkription: Tab-Audio besteht aus App-Geräuschen, Musik oder dem Video, um das es im Bug geht. Aufnahmen aus älteren SDKs haben diesen Vermerk nicht und gehen immer in die Transkription, wenn sie Ton enthalten.
Whisper füllt Stille mit Wörtern
Ich habe whisper-1 von OpenAI genommen, für 0,006 $ pro Minute. Jede Zeile kommt mit Zeitstempeln und drei Werten zurück: wie wahrscheinlich die Zeile Stille ist, wie sicher sich das Modell bei den Wörtern ist und wie stark sich der Text wiederholt. In meinen Tests machte das Modell aus einem stummen Clip ein selbstsicheres „you“. Ein 440-Hz-Ton kam ebenfalls als „You“ zurück.
Whispers eigene Regel verwirft eine Zeile nur, wenn zwei Signale übereinstimmen: Die Zeile ist wahrscheinlich Stille, und das Modell ist sich der Wörter nicht sicher. Das stumme „you“ bekam 0,94 für Stille, seine Wörter aber ziemlich sichere −0,5, also kam es durch. BugDump nimmt dieselben drei Schwellenwerte, mit denen Whisper ausgeliefert wird, verwirft eine Zeile aber schon, wenn einer davon überschritten ist:
Wert | Zeile verworfen bei | Was er abfängt |
|---|---|---|
| über 0,6 | Stille, die das Modell aufgefüllt hat |
| unter −1 | einen unsicheren Rateversuch |
| über 2,4 | eine Wiederholungsschleife |
Das „You“ des Tons bekam −1,9 und scheitert an der zweiten Schwelle. Echte Sprache lag bei etwa 0,01 und −0,3, weit weg von beiden Grenzen.
Die erfundene Zeile, die kein Wert abfängt
Ich habe mich aufgenommen, wie ich nach zehn Sekunden Stille ein paar leise Sätze auf Russisch sage, und dieselbe Datei mehrmals transkribiert. Whisper wechselte zwischen einem guten Transkript, einem unsicheren, das die Filter verwarfen, und einer selbstsicheren Zeile, die ich nie gesagt habe: „Благодарю за просмотр. Подписывайтесь…“, auf Deutsch „Danke fürs Zuschauen. Abonniert den Kanal…“. Meine Vermutung: Ein Modell, das mit Audio und Untertiteln aus dem Internet trainiert wurde, weiß, wie Videos enden, und eine lange Pause klingt wie ein Ende.
Beide Fehler kosten etwas. Werfen die Filter einen echten Sprachkommentar weg, steht im Tab „Transkript“, dass keine Sprache erkannt wurde, und die Aufnahme lässt sich nicht erneut senden. Erfindet Whisper selbstsicher eine Zeile, bleibt sie im Transkript.
Mit derselben Datei habe ich gpt-4o-transcribe-diarize ausprobiert. Es hat nie eine Zeile erfunden, aber manche Durchläufe kamen leer zurück, und es kostet das Zwei- bis Dreifache. Ich bin bei whisper-1 mit den Filtern geblieben. Ein Klick auf eine Zeile spielt diese Stelle im Video ab, deshalb fällt eine erfundene schnell auf: Dort spricht niemand.
Eine Zusammenfassung in der Sprache der meldenden Person
Drei Minuten Sprachkommentar ergeben etwa 450 Wörter. Deshalb schreibt nach Whisper ein zweites, günstigeres Modell ein bis drei Sätze: was schiefging, wo und was die meldende Person erwartet hat, allein aus dem, was sie gesagt hat. Es schreibt in der Sprache, die gesprochen wurde, also bekommt ein auf Russisch eingesprochener Bericht eine russische Zusammenfassung unter einem russischen Transkript. Wenn dein Team diese Sprache nicht liest, hilft die Zusammenfassung nicht. Hat die meldende Person nichts über ein Problem gesagt, etwa „Test, eins, zwei, drei“, gibt es keine Zusammenfassung.
Der Demo-Bericht
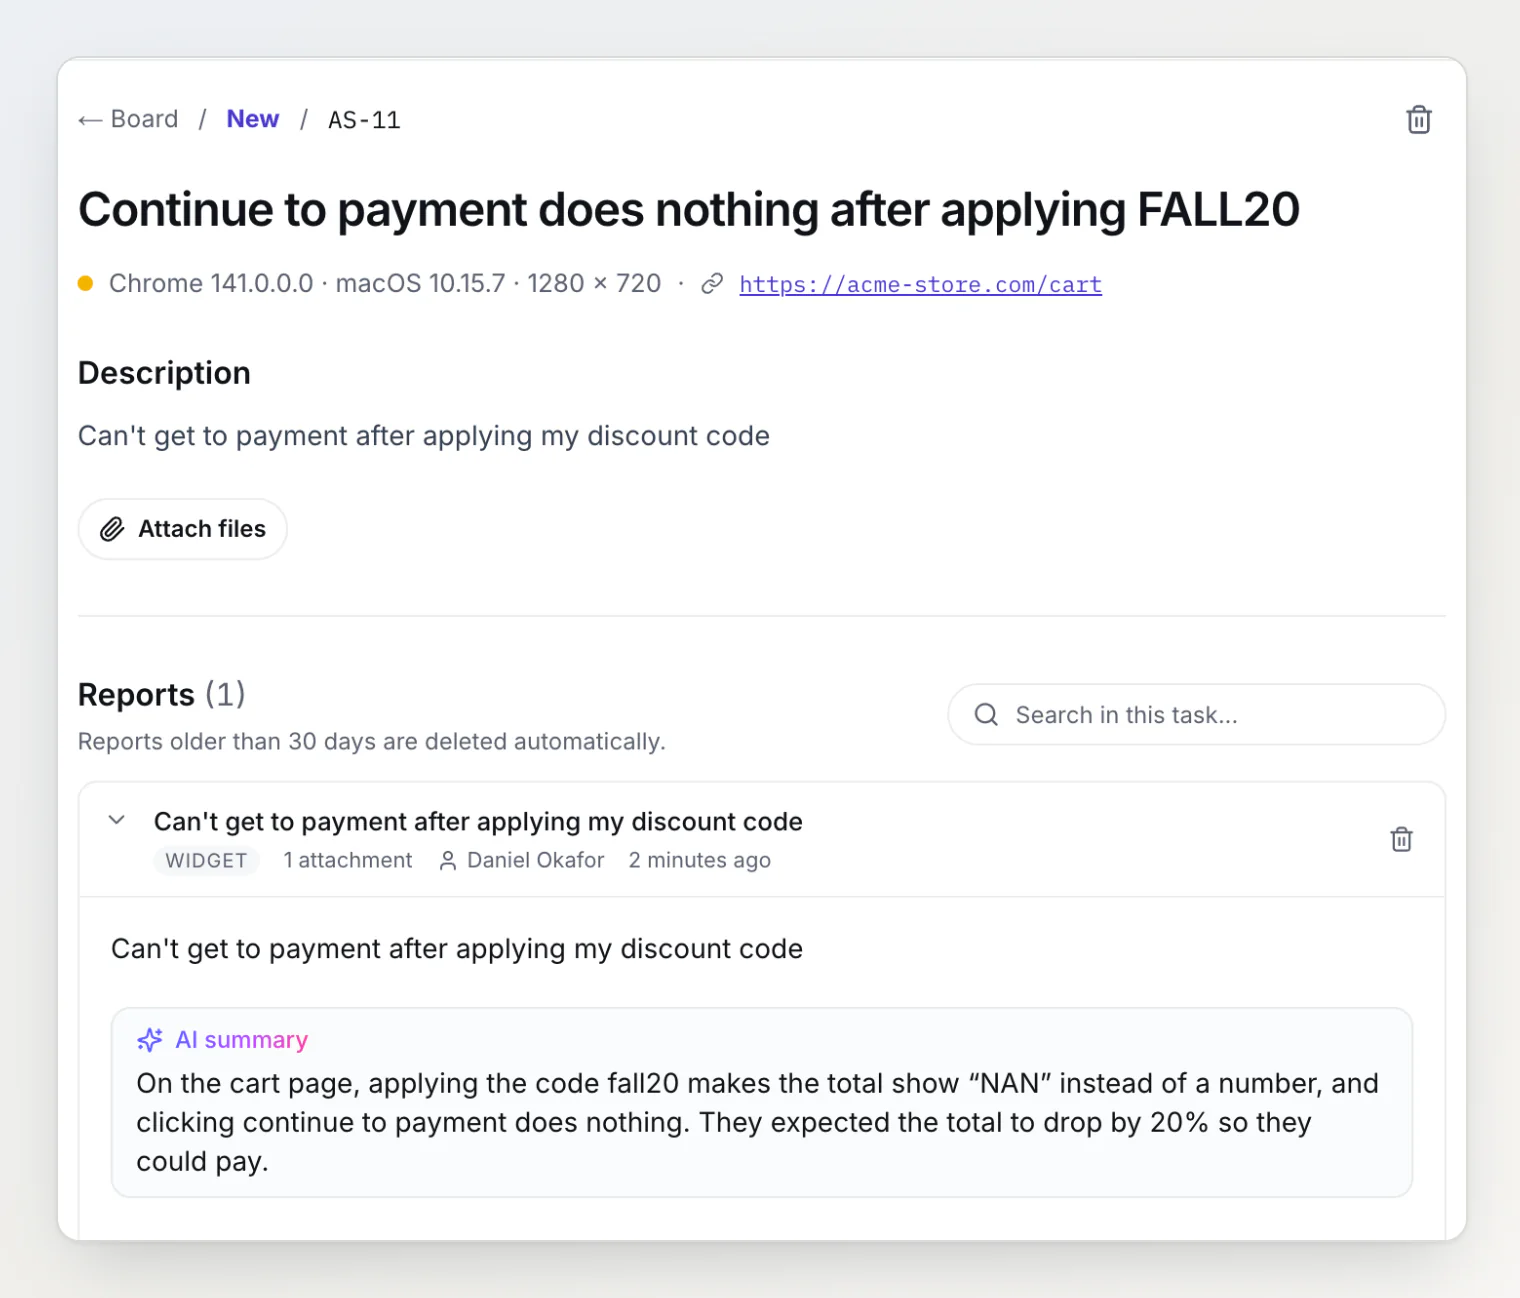
Diesen Bericht habe ich auf bugdump.com aus einem Demo-Shop gemeldet, eingesprochen von einer Text-to-Speech-Stimme: Der Gutschein FALL20 macht aus der Summe $NaN. Die Zusammenfassung steht unter der Beschreibung:
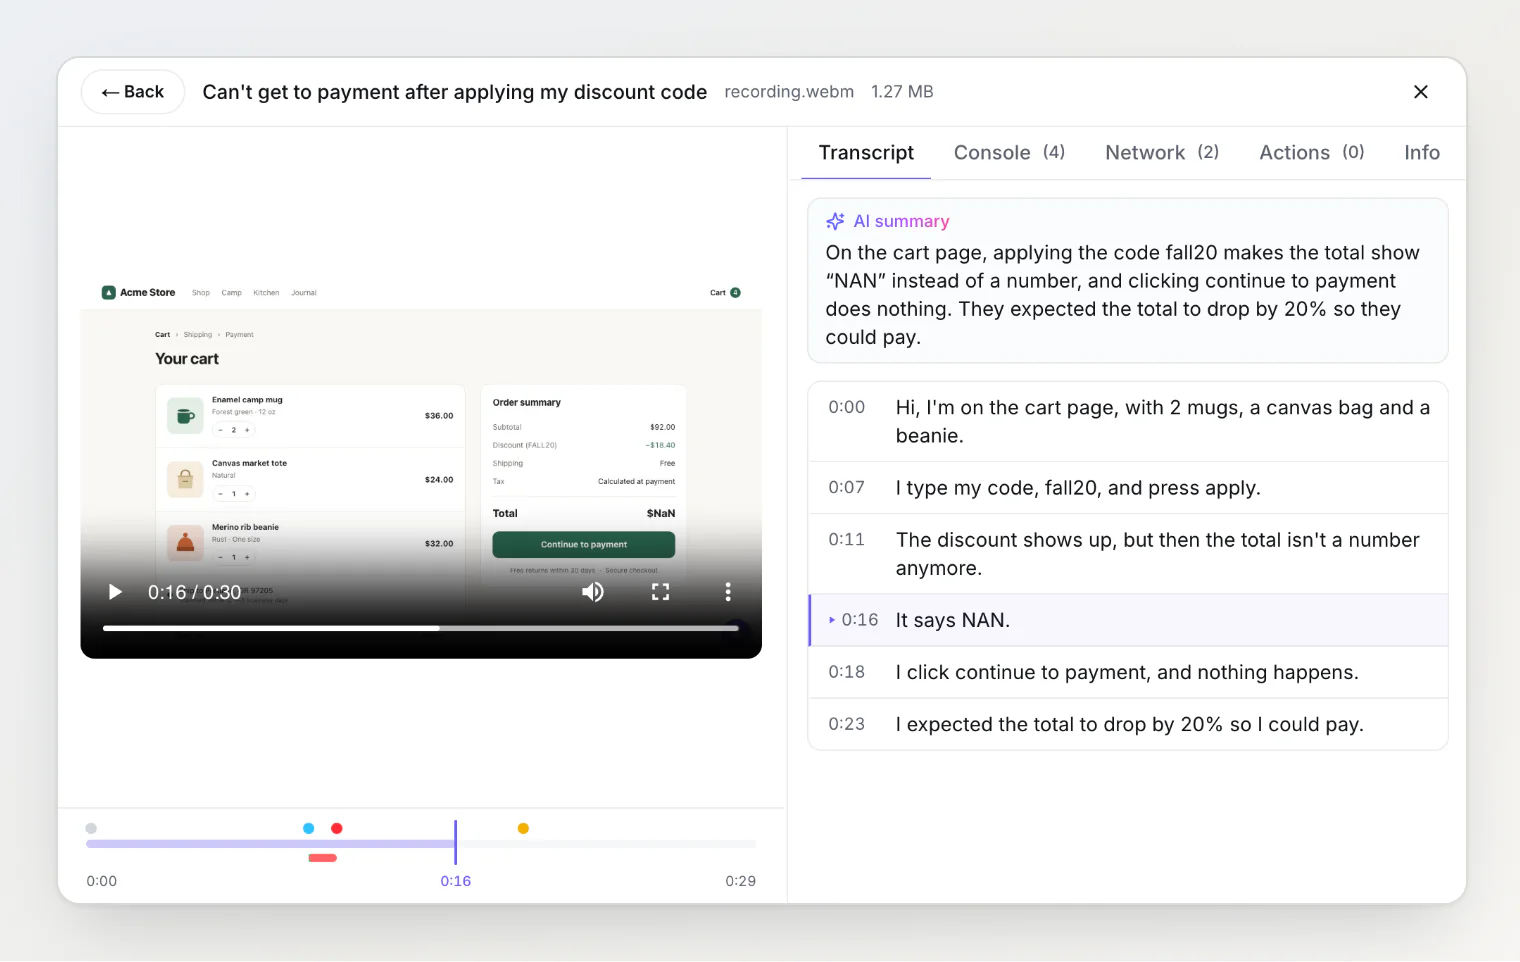
Im Player listet der Tab Transkript jede Zeile mit ihrer Zeit auf. Nach einem Klick auf „It says NAN.“ springt das Video zu 0:16, wo als Summe $NaN steht:
Claude Code und Cursor bekommen dasselbe Transkript über get_report, jede Zeile auf derselben Zeitachse wie die Console- und Netzwerkeinträge: „the total isn't a number anymore“ (die Summe ist keine Zahl mehr) beginnt bei 0:11, etwa eine Sekunde nachdem die Versand-API 503 zurückgegeben hat. Webhooks und Integrationen warten auf das Transkript und senden die Zusammenfassung mit dem Bericht: BugDump prüft alle 10 Sekunden und gibt nach 10 Minuten auf.
Die Transkription ist in jedem Projekt eingeschaltet, auch in bestehenden, mit 30 Minuten pro Monat im kostenlosen Plan, 600 bei Pro und 3.000 bei Ultra. Das extrahierte Audio und danach der Text des Transkripts für die Zusammenfassung gehen an OpenAI; das Video verlässt BugDump nie. Wer im Projekt die Owner- oder Admin-Rolle hat, schaltet die Transkription in den Projekteinstellungen aus.
Anatomie eines Fehlerberichts: was BugDump erfasst und warum – alle anderen Signale, die ein Bericht mitbringt, und welche davon Bugs lösen.
Dein KI-Agent sollte deine Fehlerberichte lesen – wie Claude Code einen Bericht über MCP liest, mit demselben
get_report, das jetzt auch das Transkript liefert.Was tun mit einem Fehlerbericht, den du nicht reproduzieren kannst – für die Berichte, bei denen selbst der Sprachkommentar nichts erklärt.