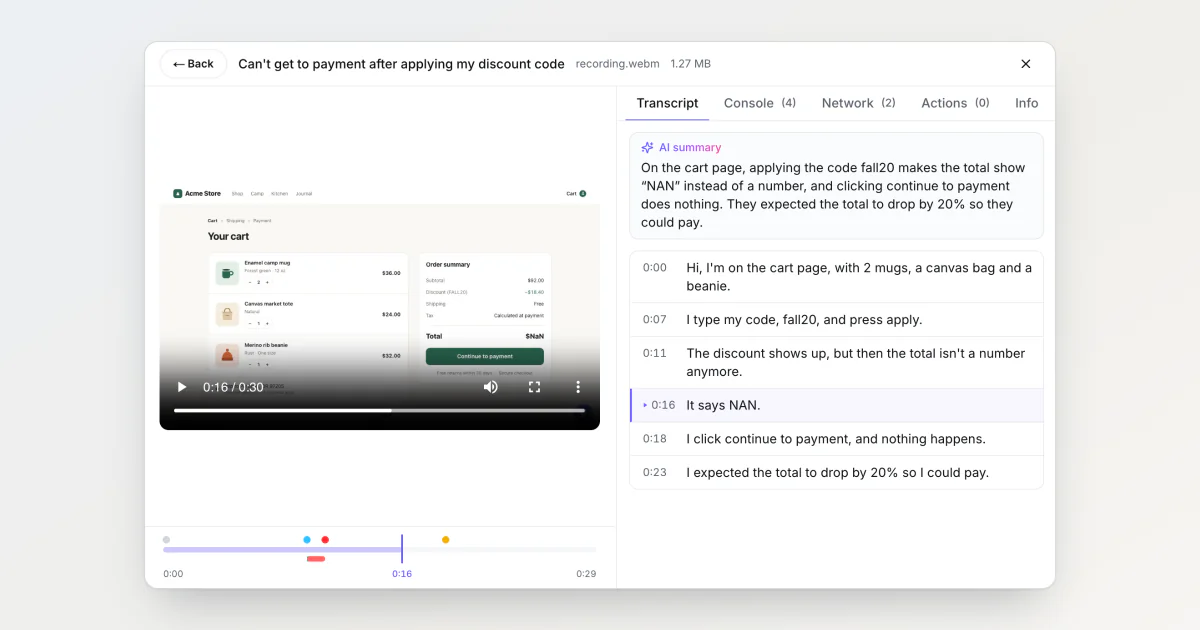
Люди говорят, пока записывают баг. Клиент открывает виджет, включает запись экрана, проходит оформление заказа и говорит: «Скидка появляется, а потом итоговая сумма перестаёт быть числом». Раньше эта фраза доходила до разработчика, только если он нажимал play и слушал.
Идею переводить её в текст я взял у FluidVoice — приложения с открытым исходным кодом, которое превращает речь в текст. Теперь BugDump расшифровывает речь в записях из виджета и добавляет сводку на одно–три предложения. По ходу работы я узнал больше о том, что Whisper делает с тишиной, чем о самой речи.
Микрофон часто не попадал в запись
Прежде чем что-то расшифровывать, я прочитал, как виджет записывает звук, и нашёл, где терялся микрофон. Виджет сводил в одну дорожку звук источника записи и микрофон, но добавлял эту дорожку в запись, только когда у источника — вкладки, окна или всего экрана — был собственный звук. Стоило выбрать окно или экран, записывать в Firefox или Safari либо не включить в Chrome звук вкладки, и кнопка микрофона горела, а его звук в запись не попадал.
SDK 0.0.49 записывает микрофон всегда, когда он включён, какой бы источник ни выбрали, и помечает в записи, был ли микрофон включён хоть в какой-то момент. Запись, сделанная с выключенным микрофоном, на расшифровку не уходит: звук вкладки — это звуки приложения, музыка или видео, о котором и заведён баг. В записях из более ранних версий SDK такой пометки нет, и они отправляются на расшифровку, если в них есть звук.
Whisper заполняет тишину словами
Я взял whisper-1 от OpenAI за $0,006 в минуту. Каждая строка приходит с таймкодами и тремя показателями: насколько вероятно, что строка — это тишина, насколько модель уверена в словах и насколько текст повторяет сам себя. В моих тестах Whisper превратил беззвучный фрагмент в уверенное «you». Тон 440 Гц тоже превратился в «You».
Собственное правило Whisper выбрасывает строку, только когда сходятся два сигнала: строка, скорее всего, тишина, и модель не уверена в словах. У беззвучного «you» показатель тишины был 0,94, но уверенность в словах — довольно высокая, −0,5, поэтому строка прошла. BugDump берёт те же три порога, что заложены в Whisper, но выбрасывает строку, если пересечён любой из них:
Показатель | Строка выбрасывается, если | Что ловит |
|---|---|---|
| выше 0,6 | тишину, которую модель заполнила словами |
| ниже −1 | неуверенную догадку |
| выше 2,4 | зацикленный повтор |
У «You» из тона было −1,9, его отсекает вторая строка таблицы. Настоящая речь набирала около 0,01 и −0,3 — далеко от обоих порогов.
Выдуманная строка, которую не ловит ни один показатель
Я записал, как после десяти секунд тишины вполголоса говорю несколько фраз по-русски, и расшифровал один и тот же файл несколько раз. Whisper выдавал то хорошую расшифровку, то неуверенную, которую выбрасывали фильтры, то уверенную строку, которую я не произносил: «Благодарю за просмотр. Подписывайтесь…». Моя догадка: модель, обученная на аудио и субтитрах из интернета, знает, как заканчиваются видео, а длинная пауза похожа на концовку.
У обеих ошибок есть цена. Если фильтры выбросят настоящий рассказ, вкладка Расшифровка сообщит, что речь не обнаружена, а отправить запись на расшифровку ещё раз нельзя. Если Whisper уверенно выдумает строку, она останется в расшифровке.
Я попробовал на том же файле gpt-4o-transcribe-diarize. Эта модель ни разу не выдумала строку, но в некоторых прогонах вернула пустую расшифровку, а стоит она в два-три раза дороже. Я оставил whisper-1 с фильтрами. Клик по строке перематывает видео на этот момент, так что выдуманную строку легко поймать: в этом месте никто не говорит.
Сводка на языке автора отчёта
Трёхминутный рассказ — это около 450 слов. Поэтому после Whisper вторая, более дешёвая модель пишет одно–три предложения: что сломалось, где и чего ждал автор отчёта — только по его словам и ни по чему больше. Она пишет на языке рассказа, так что если автор говорил по-немецки, под немецкой расшифровкой будет немецкая сводка. Если ваша команда не читает по-немецки, сводка не поможет. Если автор не сказал о проблеме ни слова, а только, например, «раз-два, проверка», сводки нет.
Демо-отчёт
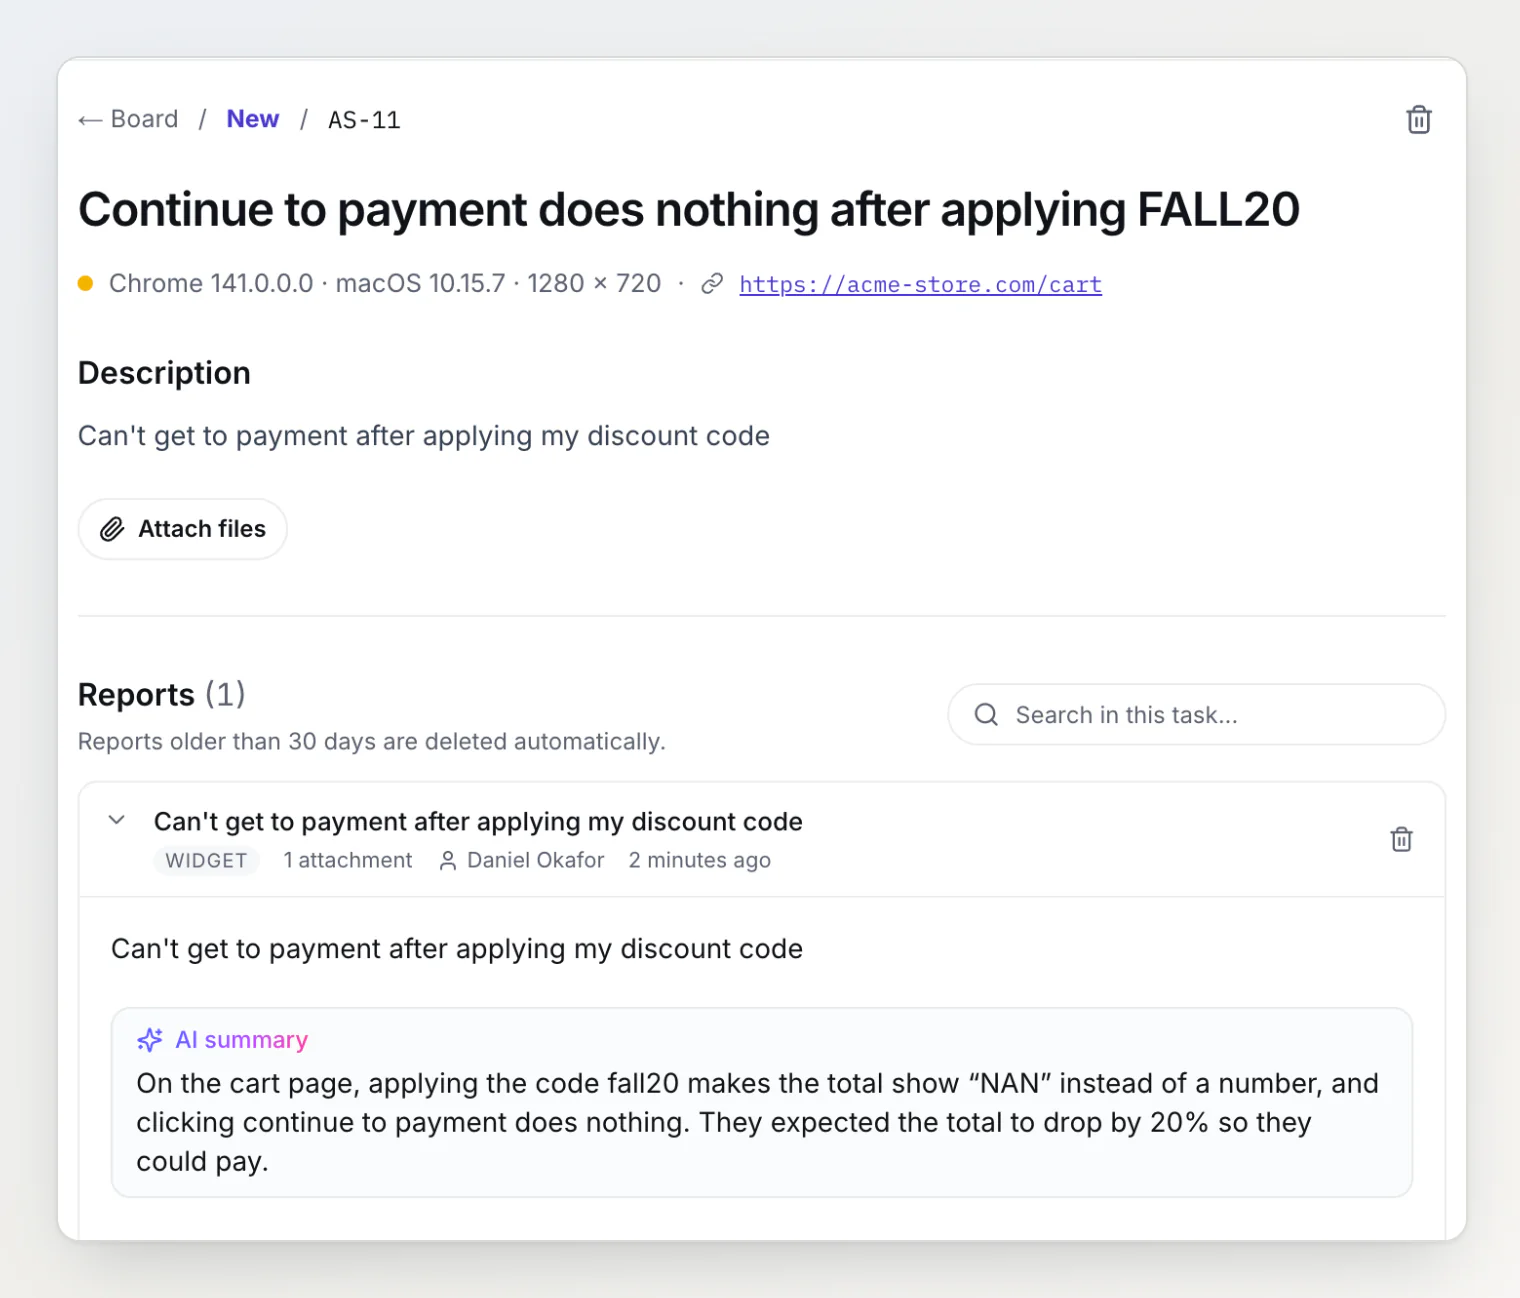
Этот отчёт я отправил на bugdump.com из демо-магазина, а рассказ за кадром прочитал синтезированный голос: купон FALL20 превращает итоговую сумму в $NaN. Сводка стоит под описанием:
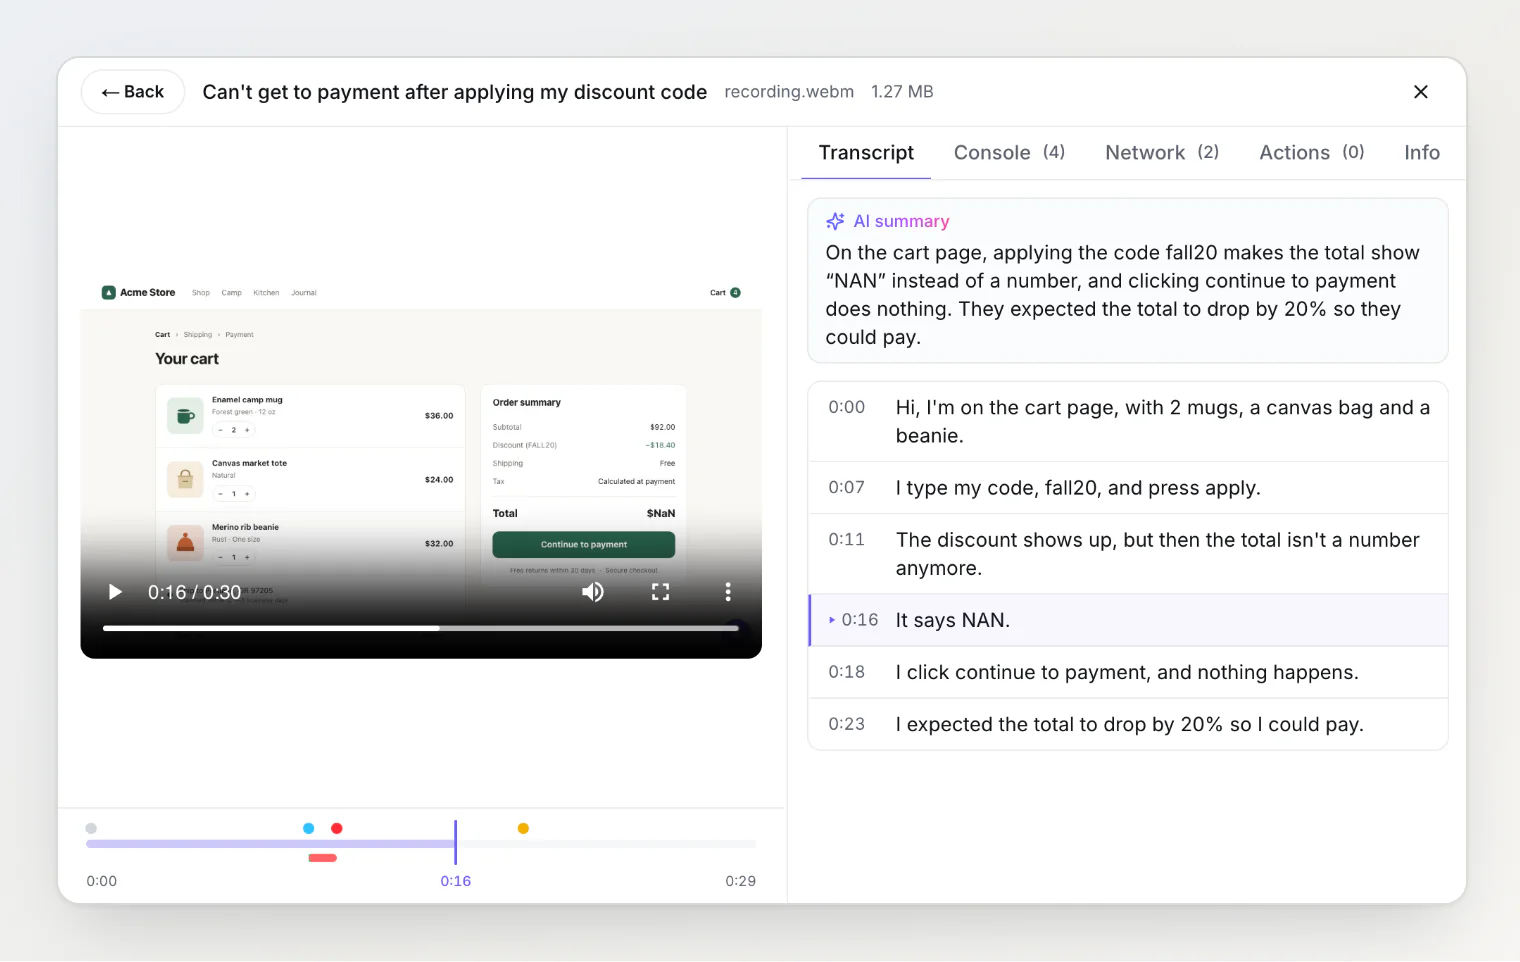
В плеере вкладка Расшифровка показывает каждую строку с таймкодом. Клик по «It says NAN.» переносит видео на 0:16, где в итоговой сумме стоит $NaN:
Claude Code и Cursor получают ту же расшифровку через get_report, и у каждой строки та же шкала времени, что и у записей консоли и сети: фраза о том, что сумма больше не число, начинается на 0:11, примерно через секунду после того, как API доставки вернул 503. Вебхуки и интеграции ждут расшифровку и отправляют сводку вместе с отчётом: BugDump каждые 10 секунд смотрит, готова ли расшифровка, и через 10 минут перестаёт ждать.
Расшифровка включена во всех проектах, в том числе в уже существующих: 30 минут в месяц на бесплатном тарифе, 600 на Pro и 3000 на Ultra. Извлечённое аудио, а затем текст расшифровки для сводки, уходят в OpenAI; видео из BugDump никуда не уходит. Владельцы и админы выключают расшифровку в настройках проекта.
Читайте также
Анатомия баг-репорта: что собирает BugDump и зачем — всё остальное, что попадает в отчёт, и что из этого помогает починить баг.
Пусть ваш ИИ-агент читает баг-репорты — как Claude Code читает отчёт через MCP, тот самый
get_report, который теперь возвращает и расшифровку.Что делать с баг-репортом, который не воспроизводится — для отчётов, где не помогает даже рассказ автора.