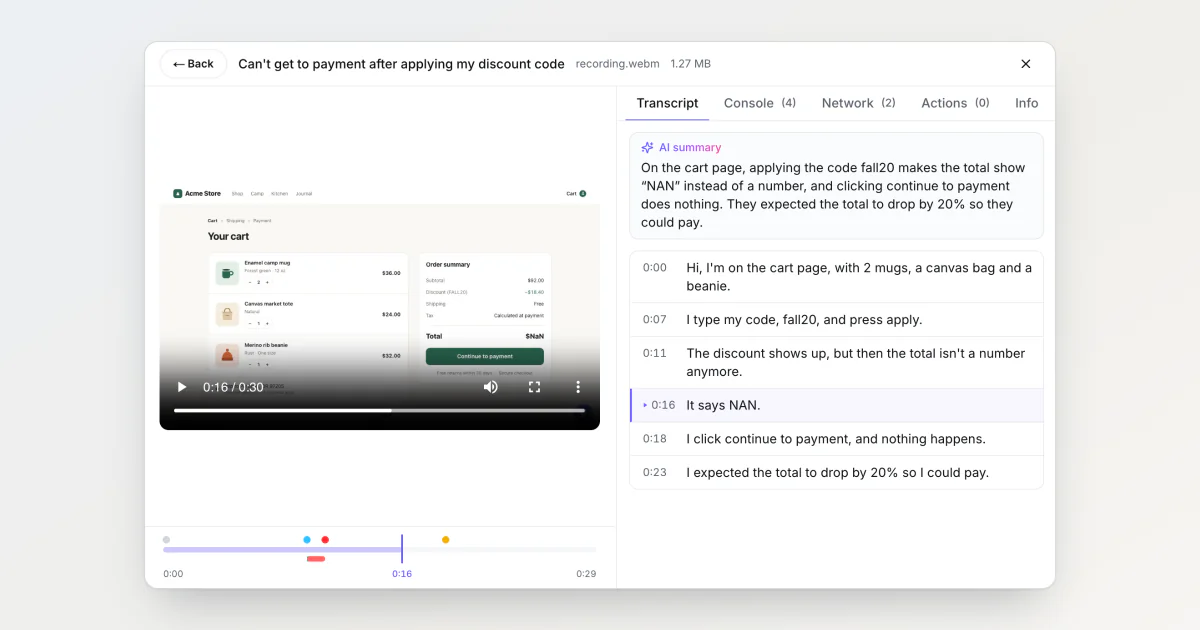
As pessoas falam enquanto gravam um bug. Um cliente abre o widget, inicia uma gravação de tela, percorre o checkout e diz «o desconto aparece, mas depois o total deixa de ser um número». Antes, essa frase só chegava ao desenvolvedor se ele desse play e ouvisse.
A ideia de transcrever veio do FluidVoice, um app open source que converte fala em texto. Agora o BugDump transcreve a fala das gravações do widget e acrescenta um resumo de uma a três frases. Chegar até aqui me ensinou mais sobre o que o Whisper faz com o silêncio do que sobre a fala.
O microfone muitas vezes ficava de fora
Antes de transcrever qualquer coisa, li como o widget grava o som, e ele muitas vezes deixava o microfone de fora. O widget mixava o som compartilhado e o microfone numa só faixa, mas só incluía essa faixa na gravação quando o que estava sendo compartilhado (uma aba, uma janela ou a tela inteira) trazia som próprio. Bastava compartilhar uma janela ou a tela, gravar no Firefox ou no Safari, ou deixar o áudio da aba desmarcado no Chrome: o botão do microfone acendia, mas o som dele nunca chegava à gravação.
O SDK 0.0.49 grava o microfone sempre que ele está ligado, independentemente do que foi compartilhado, e registra na gravação se ele esteve ligado em algum momento. Uma gravação feita com o microfone desligado não vai para a transcrição: na aba, o som vem do próprio app, de uma música ou do vídeo ao qual o bug se refere. As gravações de SDKs mais antigos não trazem essa marcação e são enviadas sempre que têm som.
O Whisper preenche o silêncio com palavras
Usei o whisper-1 da OpenAI, a US$ 0,006 por minuto. Cada linha volta com marcações de tempo e três métricas: a probabilidade de a linha ser silêncio, o quanto o modelo tem certeza das palavras e o quanto o texto se repete. Nos meus testes, ele transformou um trecho silencioso num «you» de alta confiança. Um tom de 440 Hz também voltou como «You».
A regra do próprio Whisper só descarta uma linha quando dois sinais concordam: a linha provavelmente é silêncio, e o modelo não tem certeza das palavras. O «you» silencioso marcou 0,94 de silêncio, mas as palavras dele marcaram −0,5, uma confiança razoavelmente alta, então ele passou. O BugDump usa os mesmos três limites que vêm no Whisper, mas descarta a linha quando qualquer um deles é ultrapassado:
Métrica | Linha descartada quando | O que ela pega |
|---|---|---|
| acima de 0,6 | silêncio que o modelo preencheu |
| abaixo de −1 | um palpite de baixa confiança |
| acima de 2,4 | um loop de repetição |
O «You» do tom marcou −1,9 e é descartado pela segunda linha da tabela. A fala real marcou cerca de 0,01 e −0,3, longe dos dois limites.
A linha inventada que nenhuma métrica pega
Gravei minha própria voz dizendo, baixinho, algumas frases em russo depois de dez segundos de silêncio e transcrevi o mesmo arquivo várias vezes. O Whisper alternou entre uma boa transcrição, uma de baixa confiança que os filtros jogaram fora e uma linha de alta confiança que eu nunca disse: «Благодарю за просмотр. Подписывайтесь…», ou seja, «Obrigado por assistir. Inscreva-se…». Meu palpite: um modelo treinado com áudio e legendas da internet sabe como os vídeos terminam, e uma pausa longa soa como um final.
As duas falhas têm um custo. Quando os filtros jogam fora uma narração real, a aba Transcrição diz que nenhuma fala foi detectada, e a gravação não pode ser enviada de novo para transcrição. Quando o Whisper inventa uma linha com alta confiança, ela fica na transcrição.
Testei o gpt-4o-transcribe-diarize no mesmo arquivo. Ele nunca inventou uma linha, mas algumas execuções voltaram vazias, e ele custa de duas a três vezes mais. Fiquei com o whisper-1 e os filtros. Clicar numa linha reproduz aquele momento do vídeo, então uma linha inventada é fácil de flagrar: ali ninguém está falando.
Um resumo no idioma de quem reportou
Uma narração de três minutos dá umas 450 palavras. Por isso, depois do Whisper, um segundo modelo, mais barato, escreve de uma a três frases: o que deu errado, onde e o que quem reportou esperava, a partir apenas do que foi dito. Ele escreve no idioma falado, então um relatório narrado em russo recebe um resumo em russo embaixo de uma transcrição em russo. Se a sua equipe não lê esse idioma, o resumo não vai ajudar. Quando quem reportou não descreveu problema nenhum, como em «testando, um, dois, três», não há resumo.
O relatório de demonstração
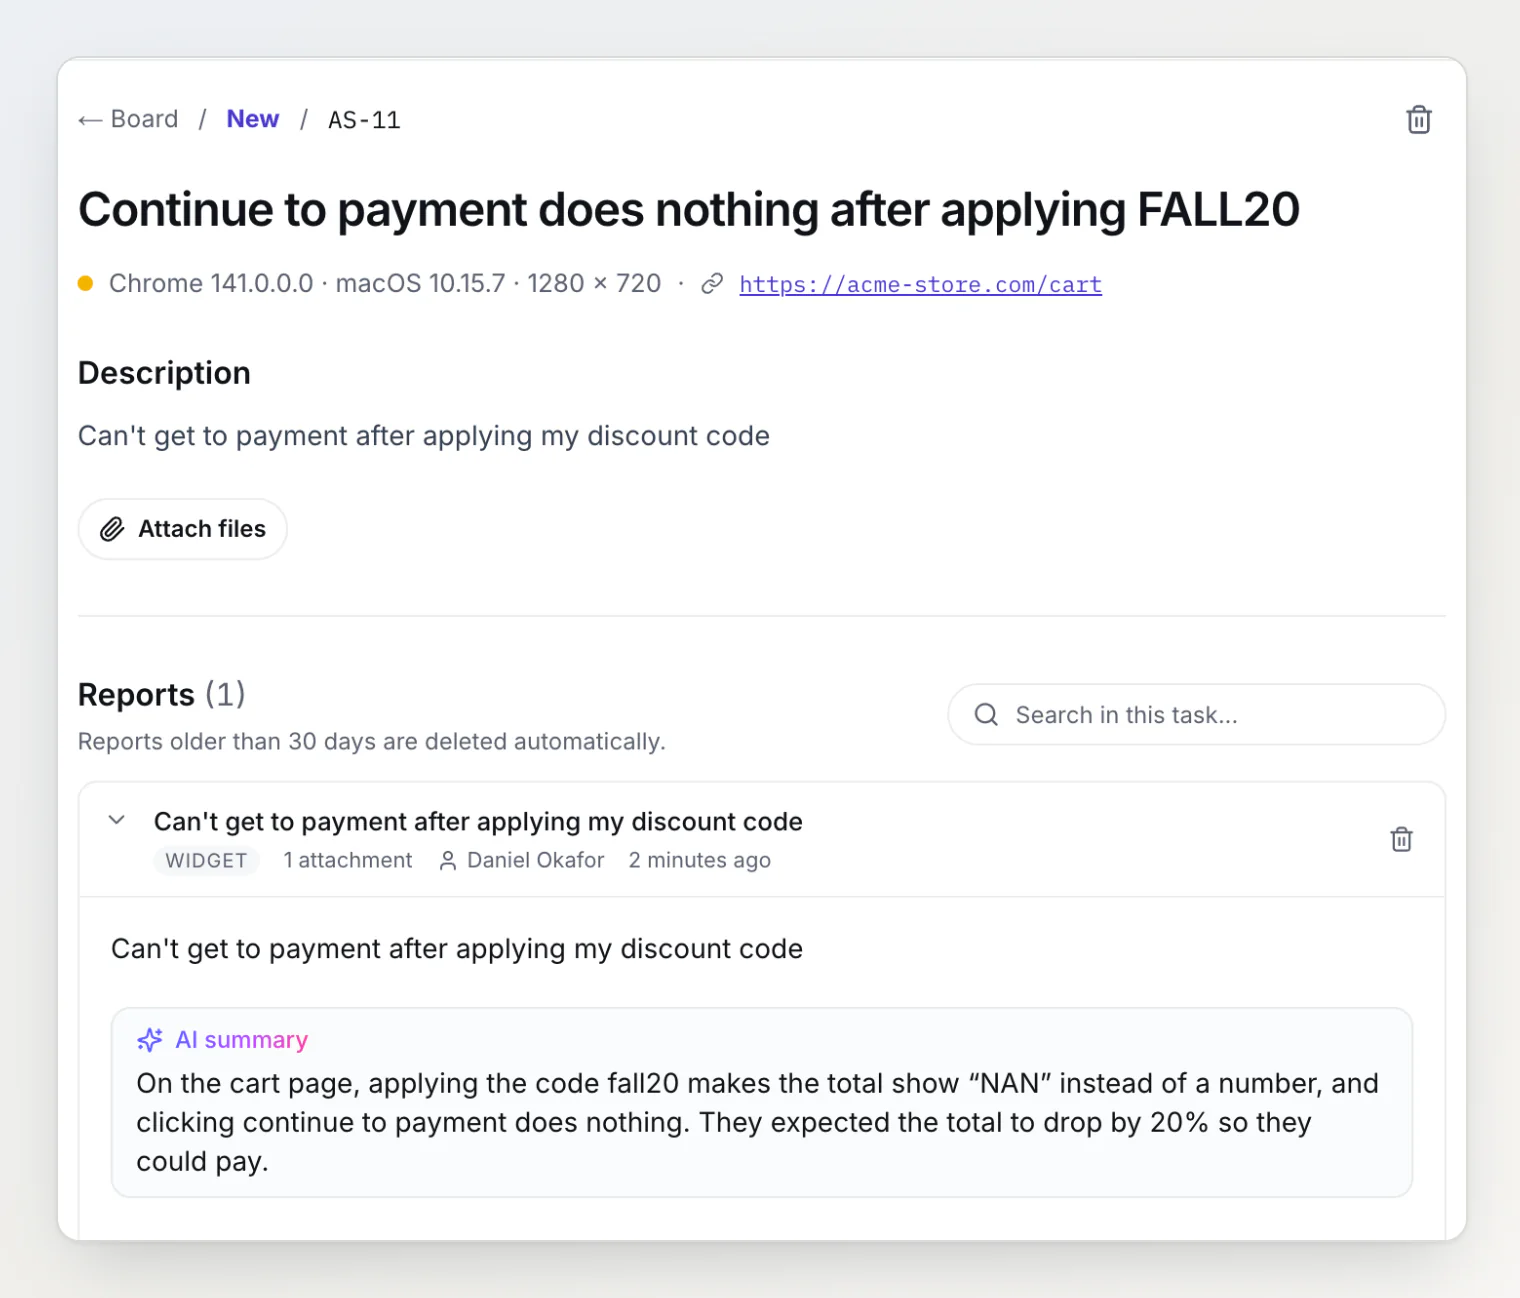
Enviei este relatório no bugdump.com a partir de uma loja de demonstração, narrado por uma voz sintética: o cupom FALL20 transforma o total em $NaN. O resumo fica embaixo da descrição:
No player, a aba Transcrição lista cada linha com a sua marcação de tempo. Clicar em «It says NAN.» leva o vídeo para 0:16, onde o total mostra $NaN:
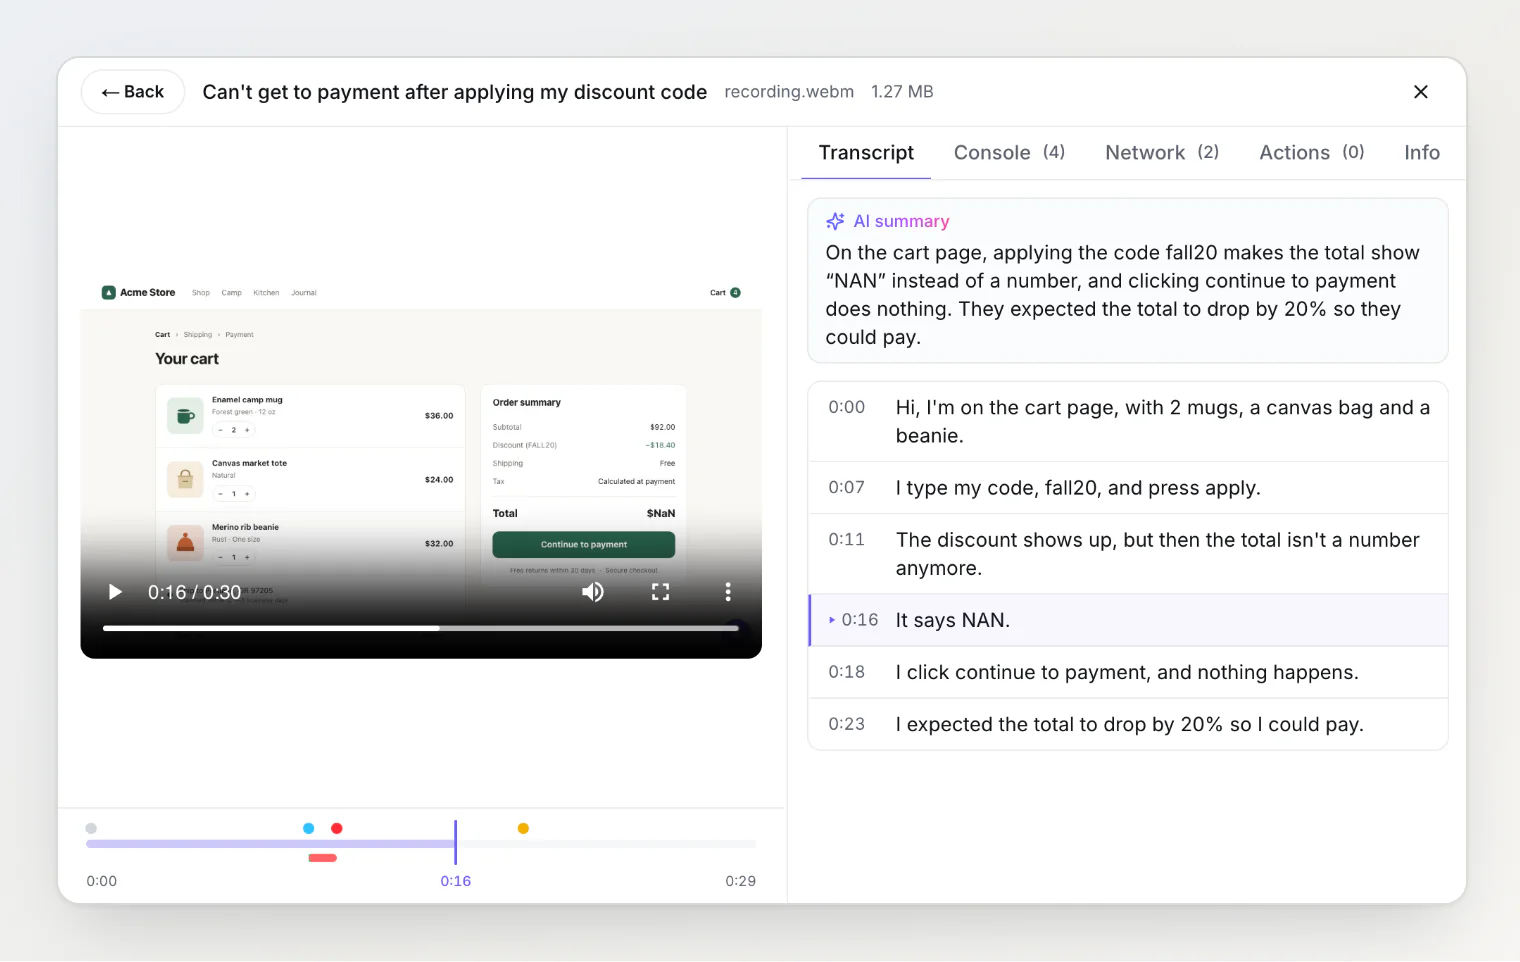
O Claude Code e o Cursor recebem a mesma transcrição pelo get_report, com cada linha na mesma escala de tempo das entradas de console e de rede: «the total isn't a number anymore» («o total deixa de ser um número») começa em 0:11, cerca de um segundo depois de a API de frete devolver 503. Webhooks e integrações esperam a transcrição e enviam o resumo junto com o relatório: o BugDump verifica a cada 10 segundos e desiste depois de 10 minutos.
A transcrição vem ligada em todos os projetos, inclusive nos que já existiam, com 30 minutos por mês no plano Grátis, 600 no Pro e 3.000 no Ultra. O áudio extraído e, depois, o texto da transcrição para o resumo vão para a OpenAI; o vídeo nunca sai do BugDump. Proprietários e admins desligam a transcrição nas configurações do projeto.
Leia também
Anatomia de um relatório de bug: o que o BugDump captura e por quê — todos os outros sinais que um relatório traz e quais deles resolvem bugs.
Seu agente de IA deveria ler os seus relatórios de bug — como o Claude Code lê um relatório pelo MCP, com o mesmo
get_reportque agora devolve a transcrição.O que fazer com um relatório de bug que você não consegue reproduzir — para os relatórios em que nem a narração explica o que aconteceu.