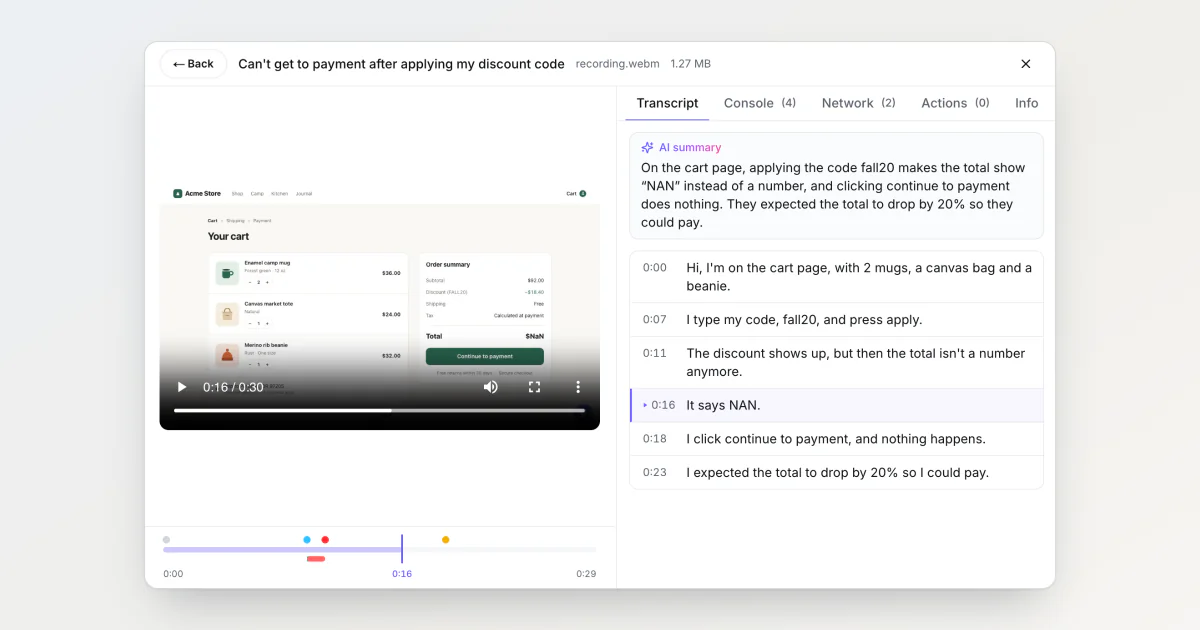
Les gens parlent pendant qu'ils filment un bug. Un client ouvre le widget, lance un enregistrement d'écran, parcourt le tunnel de commande et dit « la remise s'affiche, mais ensuite le total n'est plus un nombre ». Jusqu'ici, cette phrase n'arrivait au développeur que s'il lançait la vidéo et écoutait.
L'idée de la mettre par écrit vient de FluidVoice, une application open source qui transforme la parole en texte. BugDump transcrit désormais la parole des enregistrements faits avec le widget et y ajoute un résumé d'une à trois phrases. En chemin, j'en ai appris davantage sur ce que Whisper fait du silence que sur la parole.
Le micro manquait souvent à l'enregistrement
Avant de transcrire quoi que ce soit, j'ai regardé comment le widget enregistre le son, et il laissait souvent le micro de côté. Il mixait le son partagé et le micro sur une seule piste, mais n'ajoutait cette piste à l'enregistrement que si ce qui était partagé (un onglet, une fenêtre ou l'écran entier) apportait son propre son. Il suffisait de partager une fenêtre ou l'écran, d'enregistrer dans Firefox ou Safari, ou de laisser décochée l'option audio de l'onglet dans Chrome : le bouton du micro s'allumait, mais rien de ce qu'il captait n'arrivait dans l'enregistrement.
Le SDK 0.0.49 enregistre le micro dès qu'il est activé, quoi qu'on ait partagé, et note dans l'enregistrement s'il a été activé à un moment ou à un autre. Un enregistrement fait micro coupé n'est pas envoyé en transcription : le son d'un onglet, ce sont des bruits d'application, de la musique ou la vidéo dont parle le bug. Les enregistrements des SDK plus anciens ne portent pas cette indication et partent en transcription dès qu'ils contiennent du son.
Whisper remplit le silence de mots
J'ai pris whisper-1 d'OpenAI, à 0,006 $ la minute. Chaque ligne revient avec ses horodatages et trois scores : la probabilité que la ligne soit du silence, la confiance du modèle dans les mots, et la part de répétition dans le texte. Dans mes tests, il a transformé un extrait silencieux en un « you » plein d'assurance. Un son pur à 440 Hz est revenu lui aussi en « You ».
La règle de Whisper ne supprime une ligne que si deux signaux concordent : la ligne est probablement du silence, et le modèle n'est pas sûr des mots. Le « you » silencieux a obtenu 0,94 pour le silence, mais ses mots ont obtenu −0,5, signe que le modèle en était plutôt sûr, donc il est passé. BugDump reprend les trois seuils livrés avec Whisper, mais supprime une ligne dès que l'un d'eux est franchi :
Score | Ligne supprimée si | Ce qu'il repère |
|---|---|---|
| supérieur à 0,6 | un silence que le modèle a rempli |
| inférieur à −1 | une supposition peu sûre |
| supérieur à 2,4 | une boucle de répétition |
Le « You » du son pur a obtenu −1,9 et il est écarté par la deuxième ligne du tableau. La vraie parole obtenait environ 0,01 et −0,3, loin des deux seuils.
La ligne inventée qu'aucun score ne repère
Je me suis enregistré en train de dire quelques phrases à voix basse en russe après dix secondes de silence, puis j'ai transcrit le même fichier plusieurs fois. Whisper alternait entre une bonne transcription, une transcription peu sûre que les filtres jetaient, et une ligne pleine d'assurance que je n'ai jamais prononcée : « Благодарю за просмотр. Подписывайтесь… », c'est-à-dire « Merci d'avoir regardé. Abonnez-vous… ». Mon hypothèse : un modèle entraîné sur l'audio et les sous-titres d'Internet sait comment finissent les vidéos, et une longue pause ressemble à une fin.
Les deux échecs ont un coût. Quand les filtres jettent de vraies paroles, l'onglet Transcription indique qu'aucune parole n'a été détectée, et l'enregistrement ne peut pas être renvoyé. Quand Whisper invente une ligne avec assurance, elle reste dans la transcription.
J'ai essayé gpt-4o-transcribe-diarize sur le même fichier. Il n'a jamais inventé de ligne, mais certains essais sont revenus vides, et il coûte deux à trois fois plus cher. J'ai gardé whisper-1 avec les filtres. Un clic sur une ligne lance la vidéo à ce moment-là, donc une ligne inventée se repère vite : personne ne parle à cet endroit.
Un résumé dans la langue de l'auteur du rapport
Trois minutes de parole font environ 450 mots. Après Whisper, un second modèle, moins cher, écrit donc une à trois phrases : ce qui n'a pas marché, où, et ce que l'auteur du rapport attendait, d'après ce qu'il a dit et rien d'autre. Il écrit dans la langue que l'auteur a parlée, si bien qu'un enregistrement commenté en russe reçoit un résumé en russe sous une transcription en russe. Si votre équipe ne lit pas cette langue, le résumé ne vous aidera pas. Quand l'auteur n'a parlé d'aucun problème, comme dans un « test, un, deux, trois », il n'y a pas de résumé.
Le rapport de démonstration
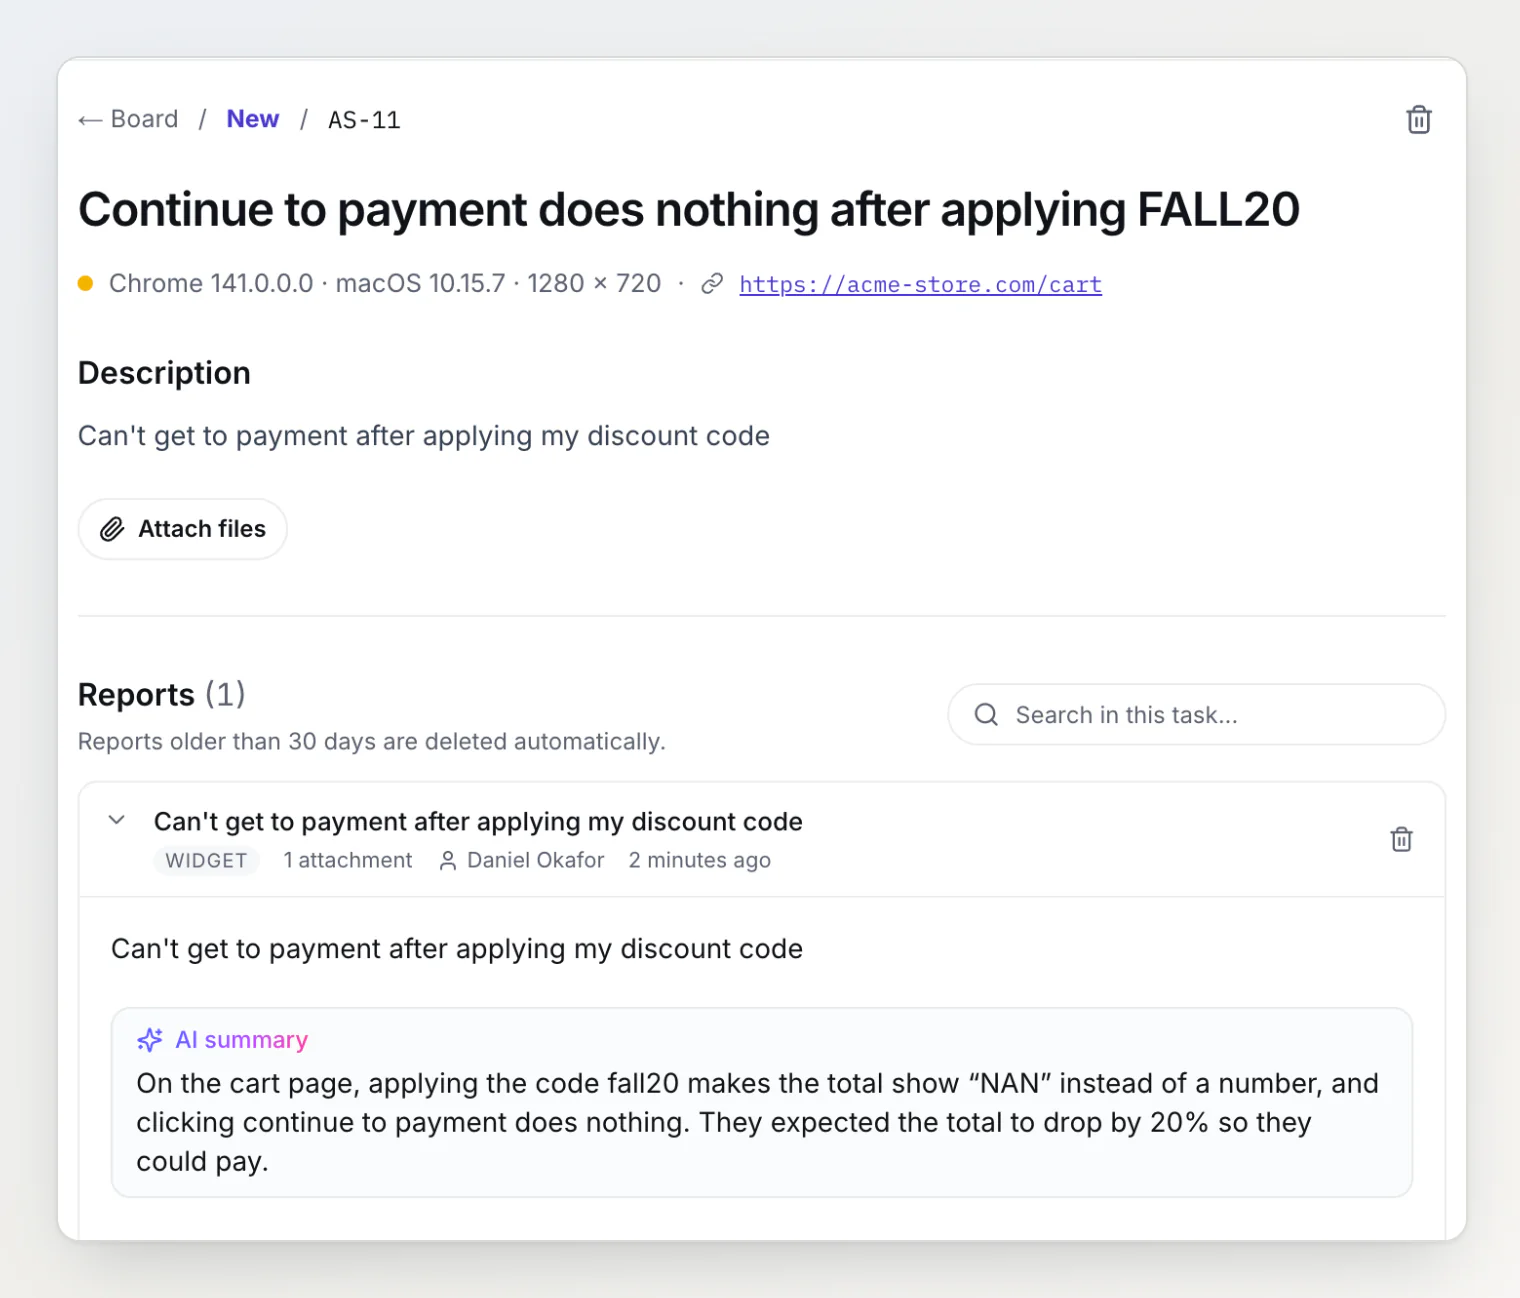
J'ai envoyé ce rapport sur bugdump.com depuis une boutique de démonstration, commenté par une voix de synthèse : le code promo FALL20 transforme le total en $NaN. Le résumé se trouve sous la description :
Dans le lecteur, l'onglet Transcription liste chaque ligne avec son horodatage. Un clic sur « It says NAN. » amène la vidéo à 0:16, où le total affiche $NaN :
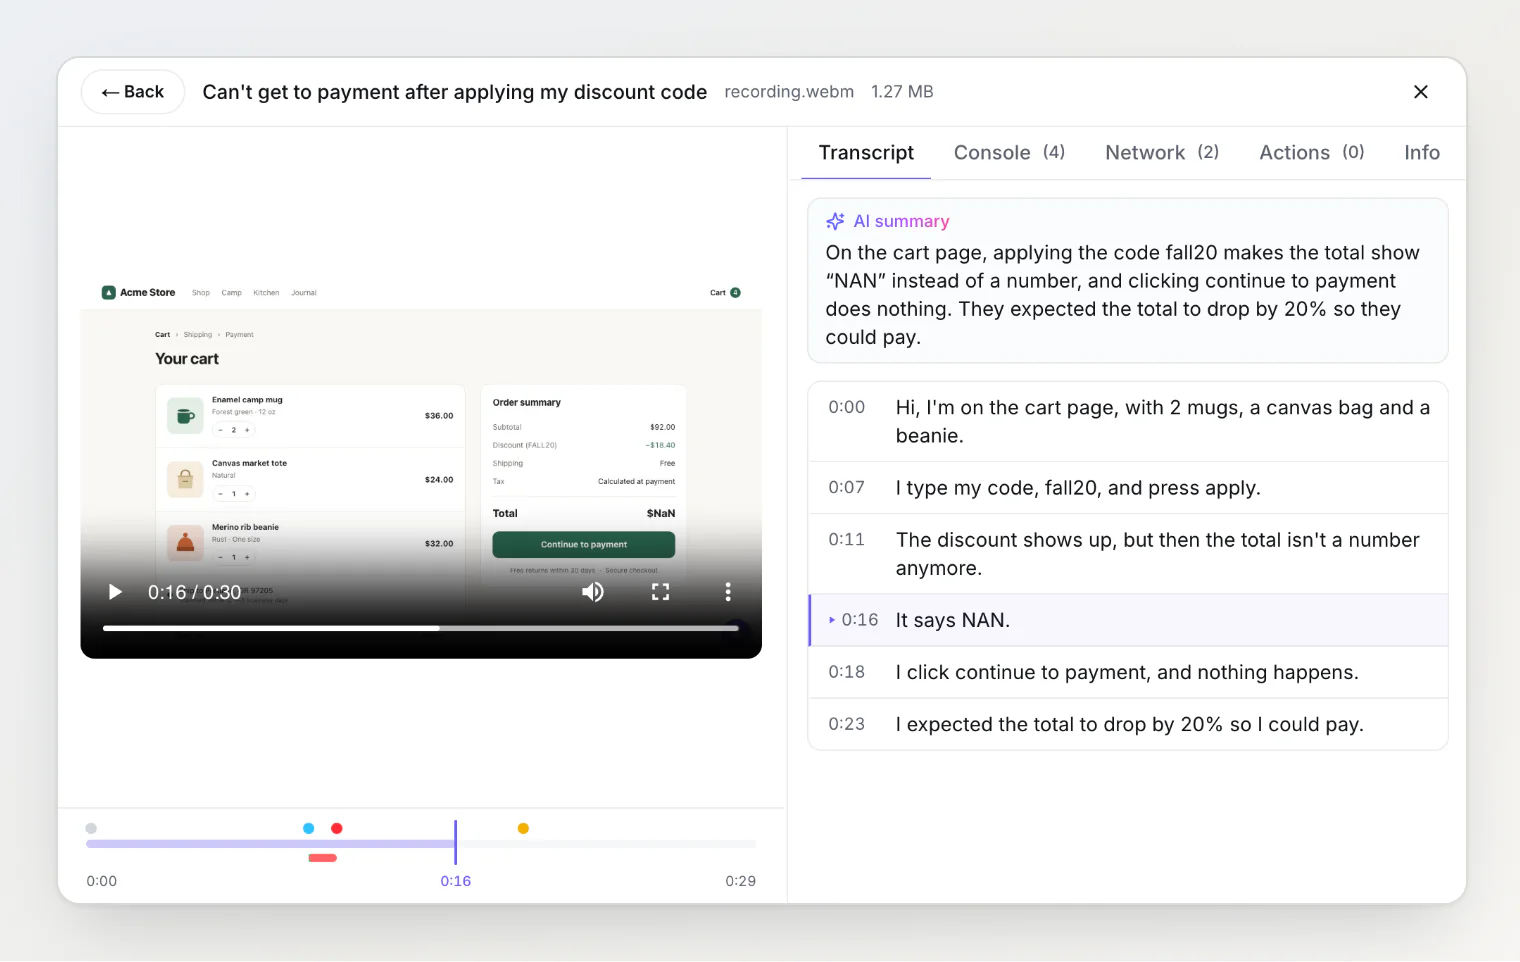
Claude Code et Cursor reçoivent la même transcription via get_report, chaque ligne calée sur la même horloge que les entrées de console et de réseau : « the total isn't a number anymore » (« le total n'est plus un nombre ») commence à 0:11, environ une seconde après que l'API de livraison a renvoyé un 503. Les webhooks et les intégrations attendent la transcription et envoient le résumé avec le rapport : BugDump vérifie toutes les 10 secondes et abandonne au bout de 10 minutes.
La transcription est activée dans tous les projets, y compris ceux qui existaient déjà, avec 30 minutes par mois sur le forfait Gratuit, 600 sur Pro et 3 000 sur Ultra. L'audio extrait, puis le texte de la transcription pour le résumé, partent chez OpenAI ; la vidéo ne quitte jamais BugDump. Les propriétaires et les admins la désactivent dans les paramètres du projet.
Pour aller plus loin
Anatomie d'un rapport de bug – ce que BugDump capture et pourquoi — tous les autres signaux que porte un rapport, et ceux qui résolvent les bugs.
Votre agent IA devrait lire vos rapports de bug — comment Claude Code lit un rapport via MCP, avec le même
get_reportqui renvoie désormais la transcription.Que faire d'un rapport de bug impossible à reproduire — pour les rapports que même le commentaire oral n'explique pas.