Ouvrez n'importe quel bug tracker et vous trouverez les quatre mêmes mots : basse, moyenne, haute, critique. Ils sont si standard que personne ne les remet en question. Pour la plupart des équipes, ils sont aussi faux, non parce que quatre serait le mauvais nombre, mais parce que ces mots sont ceux de quelqu'un d'autre.
Une échelle de priorité, c'est une décision commune compressée
Un champ de priorité ne sert pas à décrire le bug. Il sert à répondre à une seule question pour la prochaine personne qui lit le tableau : est-ce que je traite ça avant ce que j'allais faire ?
Un niveau de priorité est donc un accord compressé. « Critique » veut dire quelque chose de précis dans votre équipe : peut-être « on réveille quelqu'un », peut-être « ça part dans le prochain correctif », peut-être « on bloque la release ». Le mot ne fonctionne que si tout le monde le décompresse de la même façon.
C'est précisément pour ça qu'une échelle générique se dégrade. Personne ne s'est mis d'accord sur ce que veut dire « haute » dans votre tracker, alors chacun apporte sa propre définition, et le champ cesse de porter de l'information.
Les deux questions que l'on confond
La plupart des débats sur la priorité portent en réalité sur deux questions différentes :
Sévérité : à quel point la panne est-elle grave ? Un crash est grave. Une icône mal alignée ne l'est pas.
Priorité : quand la corriger ? Une icône mal alignée sur la page de tarifs une heure avant un lancement est urgente sans être grave.
Un seul champ ne peut pas porter les deux, et les équipes qui essaient finissent avec une échelle qui veut dire sévérité le lundi et priorité le vendredi. Choisissez-en une (pour la plupart des équipes produit, c'est la priorité qui est utile, parce que c'est elle qui change ce que vous faites ensuite), et si vous avez vraiment besoin des deux, faites de la sévérité un champ séparé.
Combien de niveaux
Moins que vous ne le pensez.
Le problème d'une longue échelle n'est pas que les gens choisissent mal ; c'est qu'ils arrêtent de choisir. Avec P0 à P4, la plupart des équipes utilisent P1 et P3 et abandonnent discrètement le reste. Vous avez une échelle à cinq niveaux qui fait le travail de deux.
Un test : pour chaque paire de niveaux voisins, pouvez-vous énoncer une règle qui tranche entre eux sans réfléchir ? Si « haute » et « moyenne » ne diffèrent qu'à l'intuition, c'est un seul niveau qui porte deux noms.
Trois niveaux appliqués de façon cohérente valent mieux que cinq choisis au jugé. Quatre est un point d'arrivée courant, parce qu'il donne deux variantes de « bientôt » et deux de « plus tard ».
L'autre règle, c'est que le niveau le plus haut doit rester rare. Si un tiers du tableau est critique, le mot a été redéfini en « ça me tient à cœur », et le tableau ne vous dit plus par où commencer. Un niveau supérieur utile décrit quelque chose pour lequel vous interrompriez votre travail, ce qui, par construction, ne peut pas représenter un tiers de quoi que ce soit.
Nommez-les comme parle votre équipe
Si, en stand-up, on demande « est-ce que c'est bloquant ? », alors Bloquant devrait être une valeur dans le tracker. Chaque étape de traduction entre la façon dont les gens parlent et ce que propose l'outil est un endroit où le champ est mal rempli ou sauté.
C'est l'argument le plus fort en faveur des priorités modifiables, et il n'a rien à voir avec la flexibilité pour elle-même. Un champ auquel les gens peuvent répondre avec leur propre vocabulaire est un champ auquel ils répondront vraiment.
Quelques échelles à reprendre telles quelles :
Équipes pilotées par le support : Bloquant · Urgent · Normal · Bas, qui se calque proprement sur un SLA.
Équipes produit : Maintenant · Ensuite · Plus tard, trois niveaux sans ambiguïté, qui servent aussi de feuille de route.
Travail rythmé par les incidents : P0 · P1 · P2 ; si votre runbook d'astreinte utilise déjà ces numéros, reprenez les mêmes ici.
Modifier l'échelle dans BugDump
BugDump démarre chaque projet avec Low, Medium, High et Critical, et aucun de ces niveaux n'est figé. Sur la page Propriétés, sélectionnez Priorité et modifiez la liste : renommez sur place, changez les couleurs, ajoutez les vôtres, supprimez ce que vous n'utilisez pas.
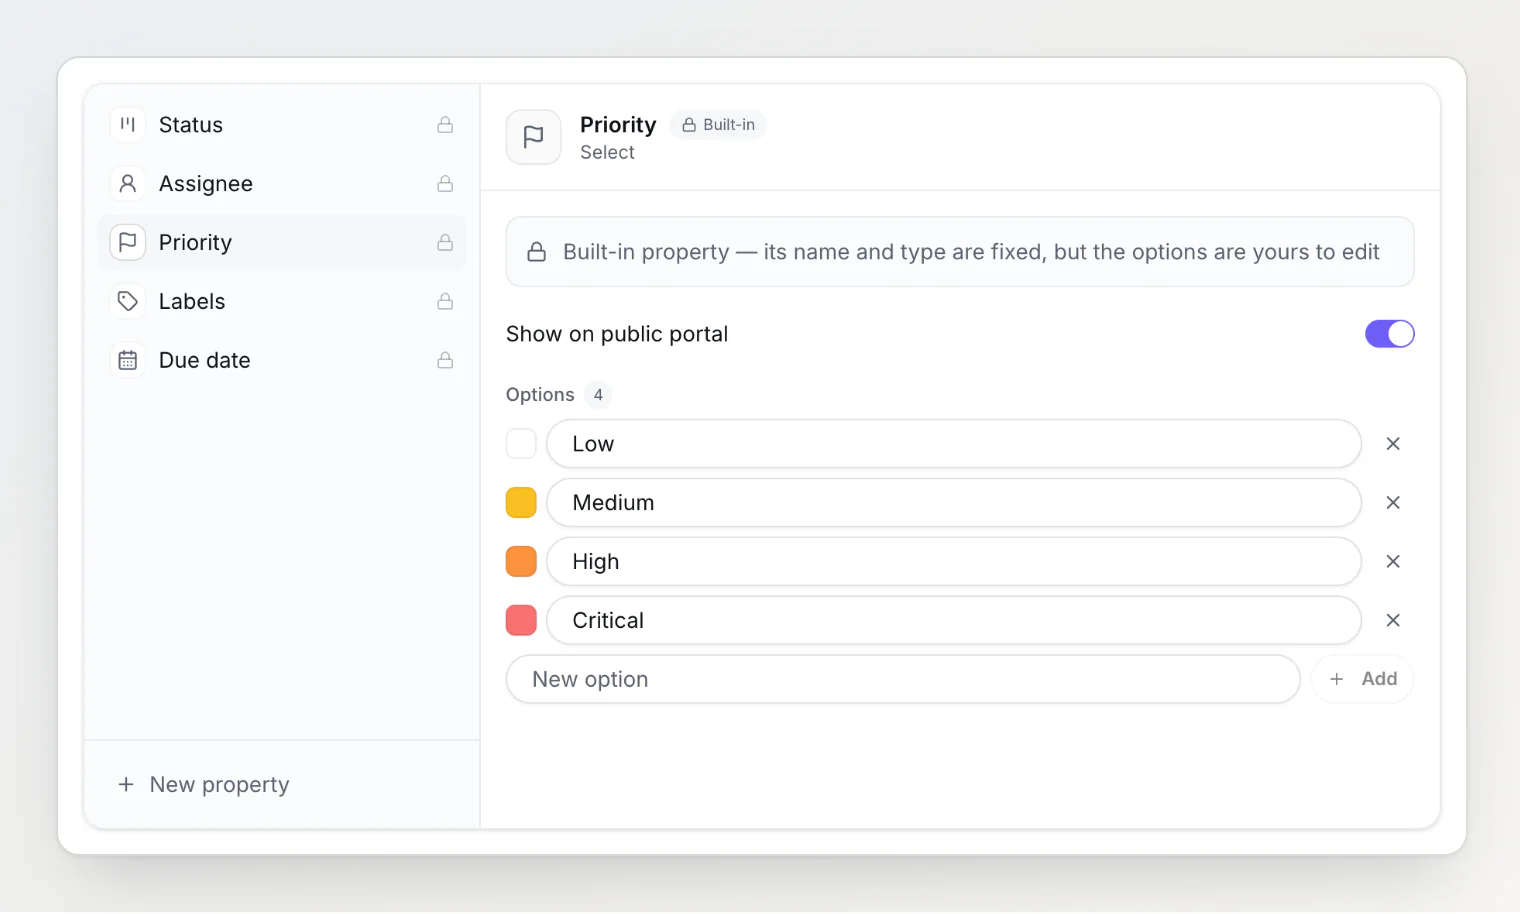
Un renommage s'applique partout à la fois. Les tâches déjà marquées Critical affichent le nouveau mot sur leurs cartes, dans le panneau de la tâche, sur le portail public et via le serveur MCP. Pas de migration ni de réétiquetage, parce que la tâche pointe vers l'option au lieu de stocker une copie de son nom.
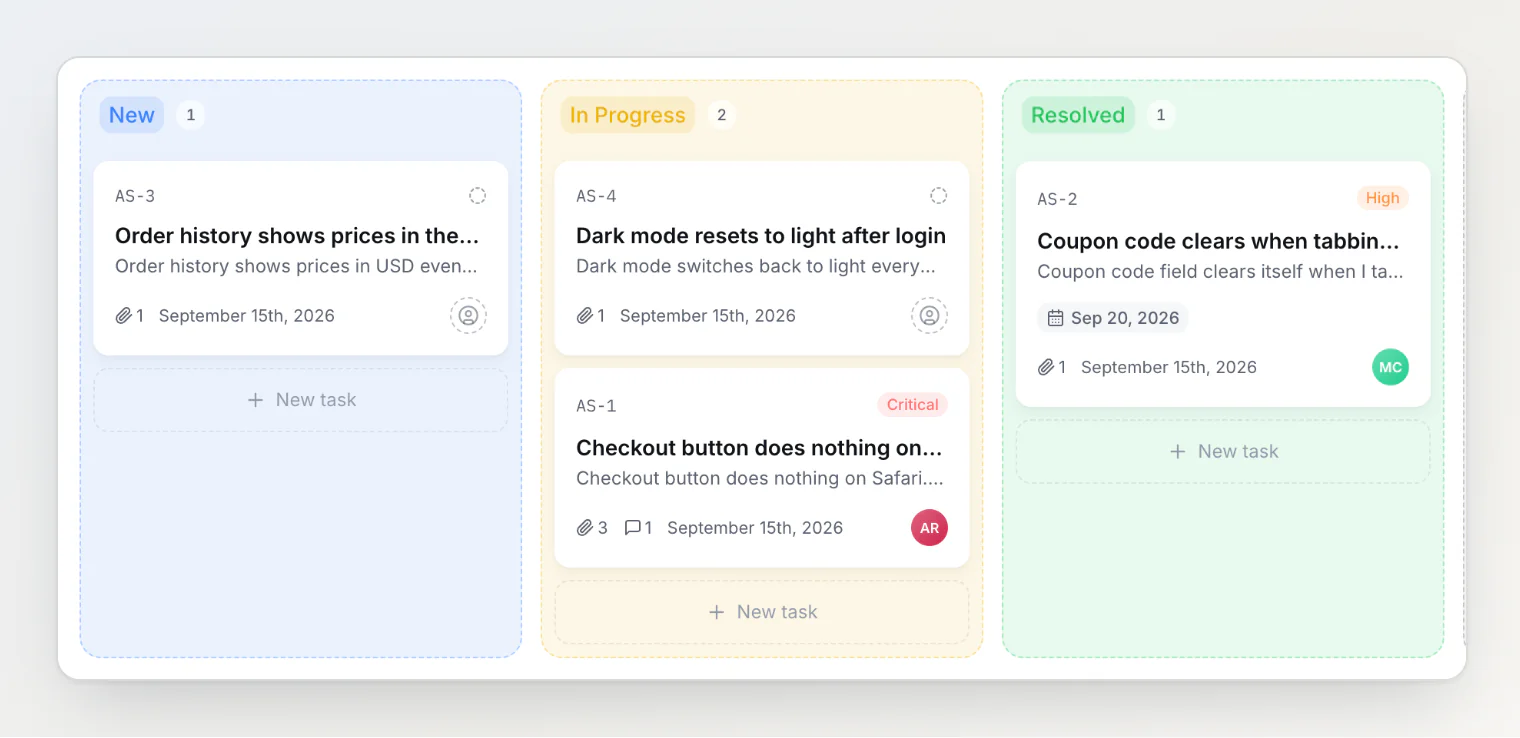
Supprimer un niveau conserve ses tâches ; elles perdent simplement cette priorité. Élaguer une échelle trop ambitieuse ne coûte donc pas grand-chose, et c'est important, parce que la plupart des équipes ne trouvent la bonne échelle qu'après avoir utilisé la mauvaise pendant un mois.
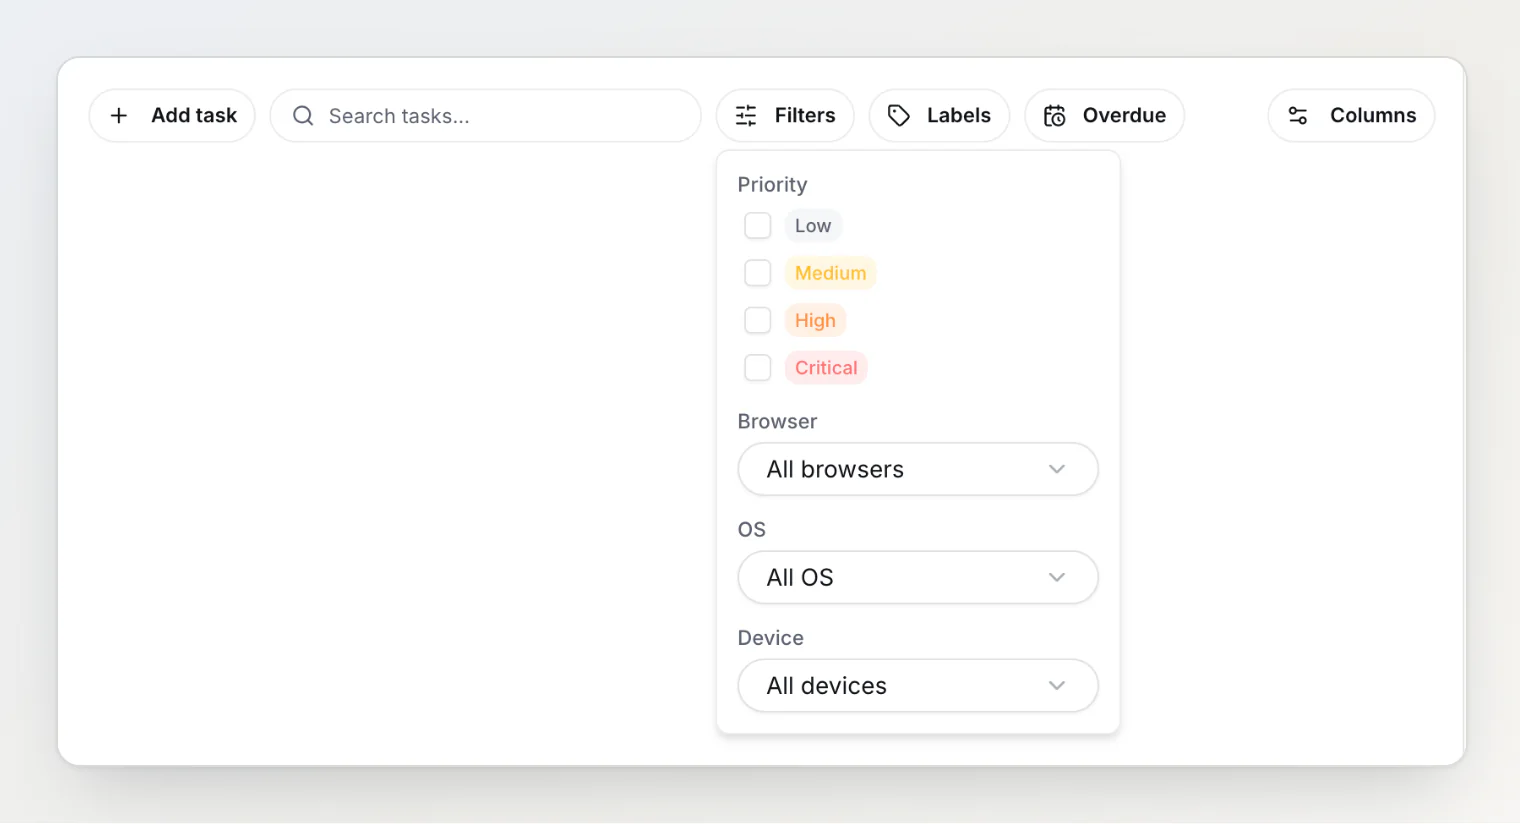
Le tableau filtre sur tout ce que contient votre liste, plusieurs valeurs à la fois.
Deux points à surveiller quand vous renommez
Tout ce qui définit une priorité par son nom. Un widget intégré qui passe priority: 'critical', ou un script qui appelle l'API. La comparaison ignore la casse, donc critical trouve toujours Critical, mais si vous renommez Critical en Bloquant, l'ancien nom ne correspond plus à rien. Les rapports anonymes arrivent toujours, simplement sans priorité ; les appels authentifiés sont rejetés pour que vous le remarquiez.
Les intégrations qui traduisent vers leurs propres sévérités. Jira et Freshdesk ont leurs propres échelles, et un niveau que vous avez inventé n'y a pas d'équivalent, donc ces tickets reçoivent la sévérité médiane de la destination. Si cette correspondance compte, ajoutez des niveaux plutôt que de renommer ceux par défaut.
Le résumé honnête
La priorité est un petit champ qui décide de l'ordre de tout le reste, et elle ne fonctionne que si l'équipe s'est vraiment mise d'accord sur le sens de chaque niveau. Un vocabulaire figé gêne cet accord. Laissez plutôt le tracker apprendre vos mots.
Ensuite, utilisez l'échelle avec un peu de discipline : gardez le niveau supérieur rare, supprimez le niveau que personne ne choisit, et revoyez-la après un mois de vrais bugs.
Pour aller plus loin
Les métriques de suivi des bugs qui comptent vraiment — les quelques chiffres qui disent si votre suivi de bugs fonctionne.
Trier les bugs plus vite avec un workflow au clavier — comment traiter une file de nouveaux rapports sans quitter le clavier, priorité comprise.
Le nom technique qui servait aussi de nom affiché — ce qui a dû changer dans le code pour que les priorités deviennent modifiables.