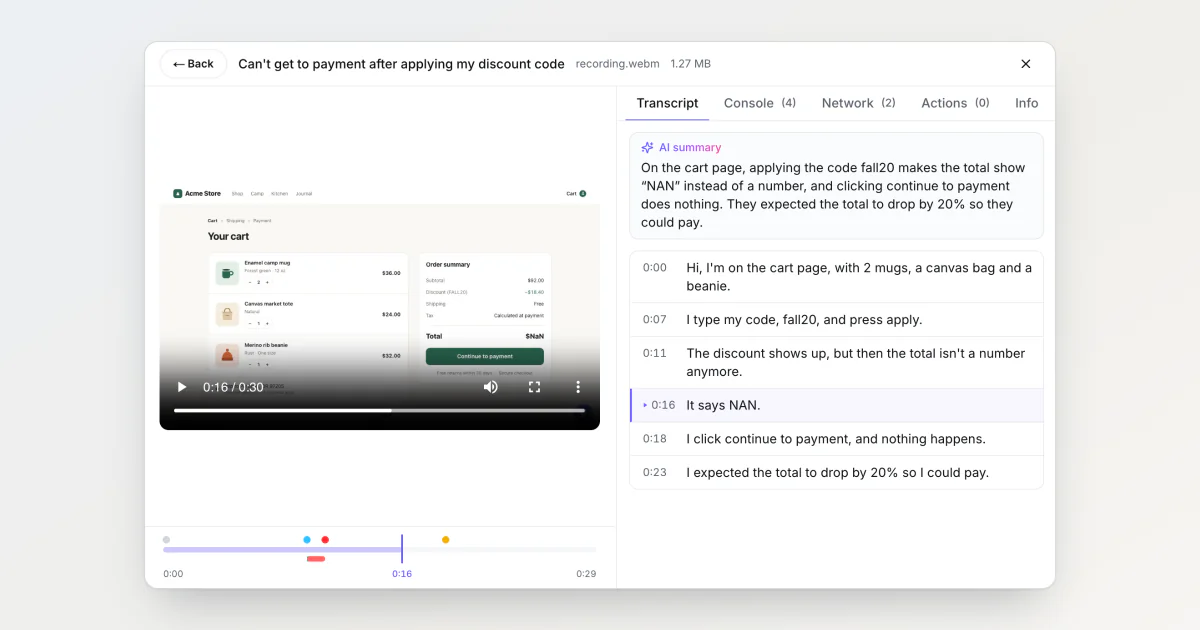
La gente habla mientras graba un bug. Un cliente abre el widget, empieza una grabación de pantalla, recorre el proceso de compra y dice «el descuento aparece, pero luego el total ya no es un número». Antes, esa frase solo llegaba al desarrollador si reproducía el video y lo escuchaba.
La idea de pasarla a texto vino de FluidVoice, una app de código abierto que convierte la voz en texto. BugDump ya transcribe la voz de las grabaciones del widget y añade un resumen de una a tres frases. Por el camino aprendí más sobre lo que hace Whisper con el silencio que sobre la voz.
La grabación a menudo se quedaba sin micrófono
Antes de transcribir nada, revisé cómo graba el sonido el widget y vi que a menudo dejaba fuera el micrófono. Mezclaba el sonido compartido y el micrófono en una sola pista, pero solo añadía esa pista a la grabación cuando lo que se compartía (una pestaña, una ventana o la pantalla entera) traía sonido propio. Bastaba con compartir una ventana o la pantalla, grabar en Firefox o Safari o dejar sin marcar el audio de la pestaña en Chrome: el botón del micrófono se encendía, pero su sonido nunca llegaba a la grabación.
El SDK 0.0.49 graba el micrófono siempre que está encendido, se comparta lo que se comparta, y anota en la grabación si estuvo encendido en algún momento. Una grabación hecha con el micrófono apagado no se envía a transcribir: el sonido de la pestaña son ruidos de la app, música o el video del que trata el bug. Las grabaciones de versiones anteriores del SDK no llevan esa marca y se envían siempre que tienen sonido.
Whisper rellena el silencio con palabras
Usé whisper-1 de OpenAI, a 0.006 USD por minuto. Cada línea llega con sus marcas de tiempo y tres puntuaciones: qué probabilidad hay de que la línea sea silencio, cuánta confianza tiene el modelo en las palabras y cuánto se repite el texto. En mis pruebas convirtió un fragmento silencioso en un «you», sin dudar. Un tono de 440 Hz también se transcribió como «You».
La regla del propio Whisper descarta una línea solo cuando coinciden dos señales: la línea probablemente es silencio y el modelo no está seguro de las palabras. El «you» del silencio tenía una probabilidad de silencio de 0.94, pero sus palabras puntuaron −0.5, una confianza bastante alta, así que pasó. BugDump usa los mismos tres umbrales que trae Whisper, pero descarta una línea en cuanto se cruza cualquiera de ellos:
Puntuación | Se descarta la línea si | Qué detecta |
|---|---|---|
| supera 0.6 | silencio que el modelo rellenó |
| baja de −1 | una conjetura poco segura |
| supera 2.4 | un bucle de repeticiones |
El «You» del tono puntuó −1.9 y lo descarta la segunda fila. La voz real puntuó alrededor de 0.01 y −0.3, lejos de ambos umbrales.
La línea inventada que ninguna puntuación detecta
Me grabé diciendo unas cuantas frases en ruso, en voz baja, después de diez segundos de silencio, y transcribí el mismo archivo varias veces. Whisper alternaba entre una buena transcripción, otra de baja confianza que los filtros descartaban y, con plena seguridad, una línea que nunca dije: «Благодарю за просмотр. Подписывайтесь…», es decir, «Gracias por ver el video. Suscríbete…». Mi hipótesis: un modelo entrenado con audio y subtítulos de internet sabe cómo terminan los videos, y una pausa larga suena a final.
Los dos fallos tienen consecuencias. Cuando los filtros descartan una narración real, la pestaña Transcripción dice «No se detectó voz», y la grabación no se puede volver a enviar. Cuando Whisper inventa una línea con seguridad, se queda en la transcripción.
Probé gpt-4o-transcribe-diarize con el mismo archivo. Nunca inventó una línea, pero algunas ejecuciones no devolvieron nada, y cuesta entre dos y tres veces más. Me quedé con whisper-1 y los filtros. Al hacer clic en una línea se reproduce ese momento del video, así que una línea inventada se detecta rápido: ahí no habla nadie.
Un resumen en el idioma de quien reporta
Una narración de tres minutos ronda las 450 palabras. Por eso, después de Whisper, un segundo modelo, más barato, escribe de una a tres frases: qué falló, dónde y qué esperaba quien reporta, a partir de lo que dijo y nada más. Escribe en el idioma en que habló, así que un reporte narrado en ruso recibe un resumen en ruso junto a una transcripción en ruso. Si tu equipo no lee ese idioma, el resumen no le servirá. Cuando quien reporta no dijo nada sobre un problema, como en «probando, uno, dos, tres», no hay resumen.
El reporte de demostración
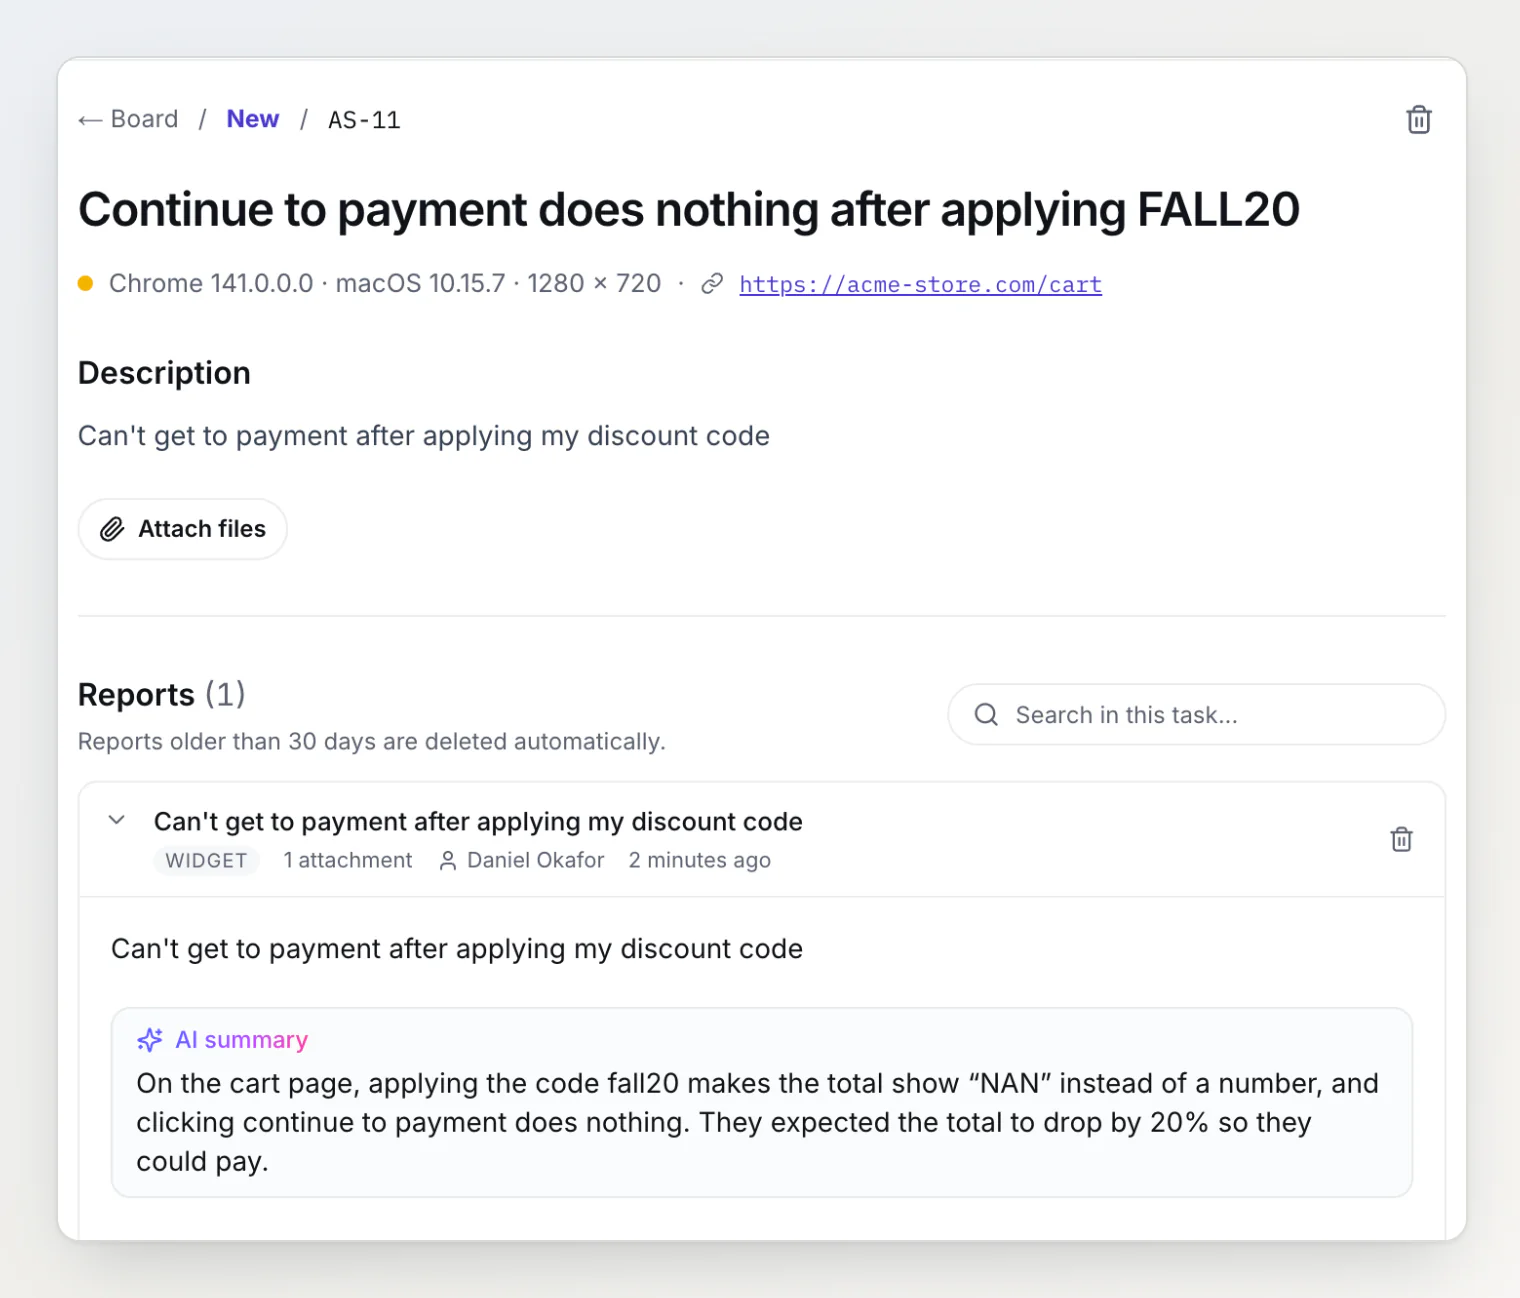
Envié este reporte en bugdump.com desde una tienda de demostración, narrado por una voz sintética: el cupón FALL20 convierte el total en $NaN. El resumen aparece debajo de la descripción:
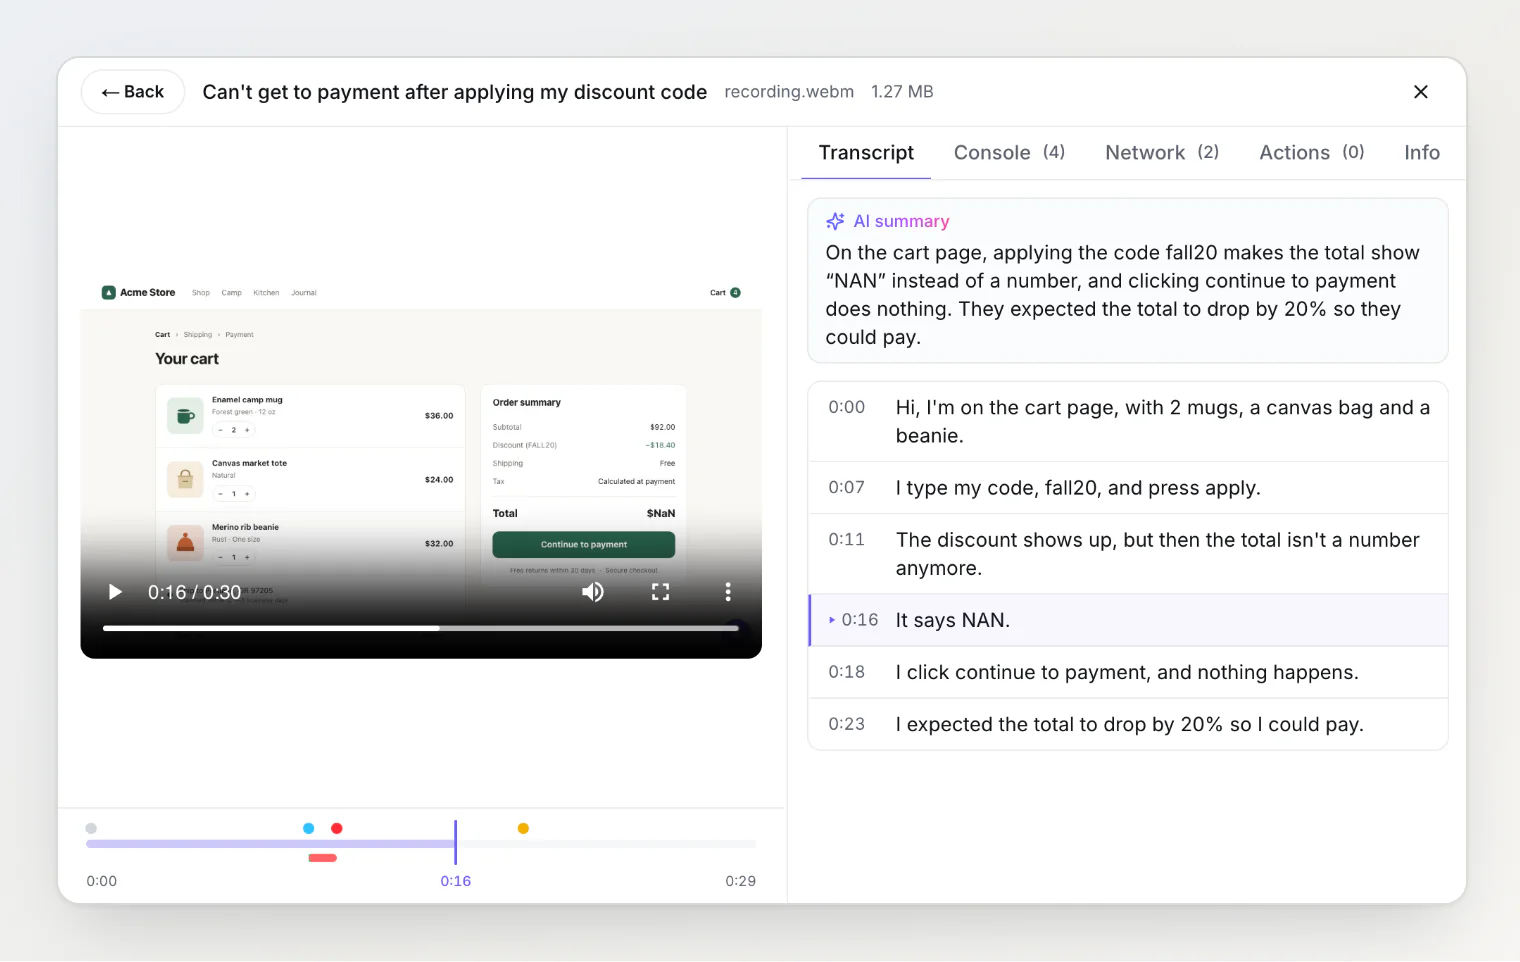
En el reproductor, la pestaña Transcripción muestra cada línea con su marca de tiempo. Al hacer clic en «It says NAN.», el video salta a 0:16, donde el total marca $NaN:
Claude Code y Cursor reciben la misma transcripción a través de get_report, con cada línea sincronizada con las entradas de consola y de red: «the total isn't a number anymore» («el total ya no es un número») empieza en 0:11, alrededor de un segundo después de que la API de envíos devolviera un 503. Los webhooks y las integraciones esperan a la transcripción y envían el resumen con el reporte: BugDump comprueba cada 10 segundos y deja de esperar a los 10 minutos.
La transcripción está activada en todos los proyectos, también en los que ya existían, con 30 minutos al mes en el plan Gratis, 600 en Pro y 3000 en Ultra. El audio extraído y, después, el texto de la transcripción para el resumen van a OpenAI; el video nunca sale de BugDump. Los propietarios y los admins la desactivan en la configuración del proyecto.
Te puede interesar
Anatomía de un reporte de bug: qué captura BugDump y por qué — todas las demás señales que lleva un reporte y cuáles resuelven bugs.
Tu agente de IA debería leer tus reportes de bug — cómo Claude Code lee un reporte por MCP, con el mismo
get_reportque ahora devuelve la transcripción.Qué hacer con un reporte de bug que no puedes reproducir — para los reportes que ni siquiera la narración explica.